


MERCADO DE GENERACIÓN DE DATOS SINTÉTICOS (2026-2033)
Pregunte ahora
Definición del mercado
Los datos sintéticos son datos artificiales diseñados para imitar datos del mundo real. Se generan de forma artificial, pero conservan las propiedades estadísticas de los datos originales a partir de los cuales se generaron. La generación de datos sintéticos puede producirse en formato tabular, multimedia o de texto. Los datos de texto sintéticos pueden ser útiles para el procesamiento del lenguaje natural (NLP). De manera similar, los datos tabulares tienen aplicaciones en la creación de tablas de bases de datos relacionales.
Los datos multimedia sintéticos incluyen imágenes, videos y otros datos no estructurados, que pueden ser cruciales para tareas de visión artificial como el reconocimiento y la clasificación de imágenes, entre otras. Existen necesidades de datos crecientes en sectores como las finanzas, la salud y el comercio minorista. Los datos sintéticos ayudan a estas organizaciones a acelerar la innovación en IA y a tomar decisiones más inteligentes.
Panorama del mercado
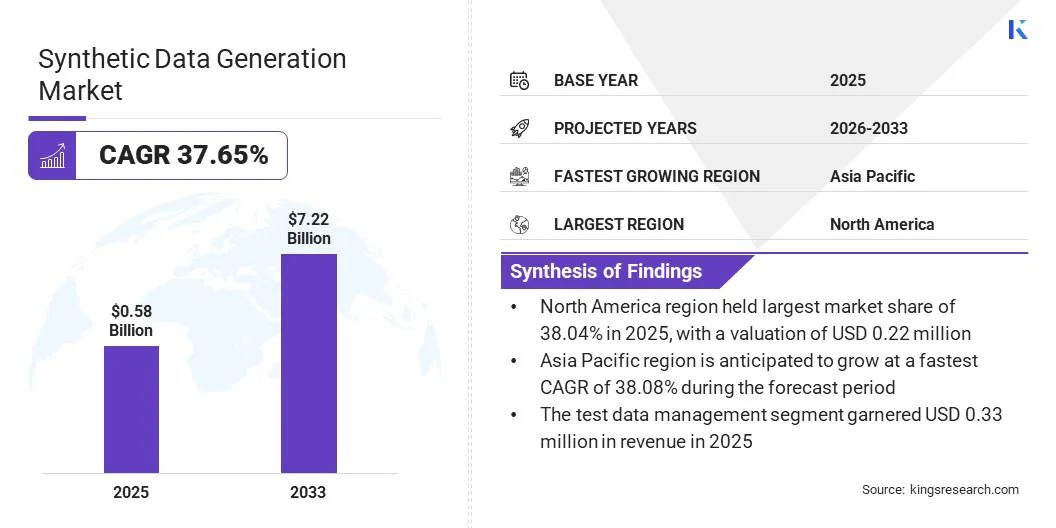
El tamaño del mercado mundial de generación de datos sintéticos se valoró en USD 0,58 mil millones en 2025 y se prevé que crezca de USD 0,77 mil millones en 2026 a USD 7,22 mil millones en 2033, con una TCAC del 37,65% durante el período de previsión. Este crecimiento se atribuye a su aplicación en sistemas de prueba, el entrenamiento de modelos de IA y la simulación de escenarios que, por lo general, resultan difíciles de captar con datos reales.
Por ejemplo, en el sector de la salud, los registros médicos sintéticos pueden representar afecciones como la diabetes, enfermedades o el cáncer, lo que puede ayudar a desarrollar y probar herramientas de diagnóstico junto con modelos de salud predictivos.
Las principales empresas que operan en el mercado global de generación de datos sintéticos son MOSTLY AI, Datagen, TonicAI, Inc., GenRocket, Inc, NVIDIA (Gretel Labs), K2view Ltd., CapGemini (Sogeti), CVEDIA Inc, Microsoft Corporation y MDClone, entre otras.
Se espera que la demanda de datos sintéticos crezca con su uso cada vez mayor en varios sectores, incluido el sector automotriz para las pruebas de vehículos autónomos, la salud para el análisis de imágenes médicas y el diagnóstico de pacientes. En el sector minorista, se usa principalmente para la gestión de inversiones y el análisis del comportamiento del cliente.
Pueden ser beneficiosos en el sector financiero para la detección de fraude y la evaluación de riesgos. Las ventajas clave de los datos sintéticos incluyen la rentabilidad, la escalabilidad y la diversidad. Se usan ampliamente para entrenar modelos de aprendizaje automático. Ofrecen un mayor control sobre la calidad de los datos y también preservan la privacidad al eliminar el uso de datos reales y sensibles.
La tendencia reciente apunta a la integración del aprendizaje federado y la privacidad diferencial para reforzar el aprendizaje automático que preserva la privacidad. Además, la demanda de conjuntos de datos de entrenamiento diversos y de alta calidad crecerá con la expansión de la IA hacia nuevos dominios, lo que hará que los datos sintéticos resulten cruciales.
Aspectos clave
- El tamaño del mercado global de generación de datos sintéticos se situó en USD 0,58 mil millones en 2025.
- Se prevé que el mercado crezca a una TCAC del 37,65% entre 2026 y 2033.
- América del Norte tuvo una participación del 38,04% en 2025, valorada en USD 0,22 mil millones.
- El segmento de datos tabulares generó USD 0,20 mil millones en ingresos en 2025.
- Se espera que el segmento de gestión de datos de prueba alcance los USD 4,05 mil millones para 2033.
- Se prevé que el segmento de salud registre la TCAC más alta, del 38,28%, durante el período de previsión.
- Se prevé que Asia-Pacífico crezca a una TCAC del 38,08% durante el período de proyección.
Dinámica del mercado
¿Qué tan confiables son los datos sintéticos para el entrenamiento de IA?
Los datos sintéticos, cuando se generan con técnicas sólidas, pueden igualar o, en algunos casos, superar a los datos reales en el rendimiento del modelo, en particular en escenarios de eventos poco frecuentes.
Si bien no pueden reemplazar a los datos reales, resultan muy eficaces como respaldo de estos, sobre todo cuando el equipo trabaja con datos limitados, conjuntos de datos desequilibrados o restricciones de privacidad. Como resultado, pueden funcionar como un complemento poderoso de los datos reales en lugar de un reemplazo total.
- En octubre de 2024, MOSTLY AI presentó su nueva funcionalidad de texto sintético para el entrenamiento de modelos de IA, que además protege la privacidad de los activos de datos propios. Permite a la organización usar una amplia variedad de datos de texto, como correos electrónicos, conversaciones de chatbot y transcripciones de atención al cliente, para entrenar y perfeccionar los modelos de lenguaje grandes (LLM), sin riesgo de violación de la privacidad.
¿Por qué el entrenamiento de sistemas de IA exige tener presente que los datos sintéticos pueden generar resultados falsos?
Los datos sintéticos pueden carecer de la complejidad y los matices de los datos del mundo real, lo que puede hacer que los modelos de IA funcionen mal en escenarios reales. Además, existe la posibilidad de que los modelos entrenados por completo con datos sintéticos no logren generalizar de forma efectiva a situaciones reales, debido a las diferencias entre los datos sintéticos y los reales. Esto también podría plantear inquietudes éticas en algunas aplicaciones, como el diagnóstico médico.
¿Cómo ofrece la generación de datos sintéticos ventajas comerciales en términos de costo y escalabilidad?
La recopilación de datos reales es costosa y lenta, dado que implica la implementación de sensores, el etiquetado y la seguridad. En cambio, los datos sintéticos para el aprendizaje automático en línea pueden generarse fácilmente de forma más económica y rápida. Los datos sintéticos ofrecen fuentes de datos controladas y escalables para un desarrollo sólido de la IA. Por ejemplo, organizaciones como Nvidia y Databricks ofrecen herramientas como Unity Catalog y Omniverse Replicator para automatizar los flujos de generación de datos sintéticos. Se estima que entre el 50% y el 60% de los datos usados para entrenar plataformas de IA son sintéticos. Su demanda aumenta porque ayudan a las organizaciones a simular nuevos productos, acelerar el desarrollo de modelos de IA y proteger información sensible.
- En octubre de 2025, GenRocket anunció el lanzamiento de su Unstructured Data Accelerator (UDA), que ha permitido a esta organización de generación de datos sintéticos basada en el diseño ampliar su plataforma más allá de los datos estructurados hasta imágenes, documentos y formatos basados en archivos. Esto le ha ayudado a generar cualquier tipo de dato de forma segura, precisa y a escala, bajo demanda.
Panorama del informe de mercado
|
Segmentación |
Detalles |
|
Por tipo de datos |
Datos tabulares, datos de texto, datos de imagen y video, otros |
|
Por aplicación |
Gestión de datos de prueba, entrenamiento y desarrollo de IA, intercambio de datos empresariales, análisis y visualización de datos |
|
Por usuario final |
Servicios financieros, comercio minorista, salud y otros |
|
Por región |
América del Norte: EE. UU., Canadá, México |
|
Europa: Francia, Reino Unido, España, Alemania, Italia, Rusia, resto de Europa | |
|
Asia-Pacífico: China, Japón, India, Australia, ASEAN, Corea del Sur, resto de Asia-Pacífico | |
|
Oriente Medio y África: Turquía, EAU, Arabia Saudita, Sudáfrica, resto de Oriente Medio y África | |
|
América del Sur: Brasil, Argentina, resto de América del Sur |
Segmentación del mercado
- Por tipo de datos (datos tabulares, datos de texto, datos de imagen y video, y otros): el segmento de datos tabulares generó USD 0,20 mil millones en ingresos en 2025, impulsado sobre todo por su creciente adopción en los sectores de comercio electrónico y salud. Se usa ampliamente para entrenar de forma eficaz algunos modelos de aprendizaje automático.
- Por aplicación (gestión de datos de prueba, entrenamiento y desarrollo de IA, intercambio de datos empresariales, y análisis y visualización de datos): se prevé que el segmento de entrenamiento y desarrollo de IA registre una TCAC extraordinaria del 38,08% durante el período de previsión, impulsado por su amplio uso en el entrenamiento de modelos de aprendizaje automático. Funciona como una solución potencial para los casos en que se necesitan datos, pero hay escasez de datos reales de alta calidad para entrenar modelos de IA.
- Por usuario final (servicios financieros, comercio minorista, salud, y otros): se estima que el segmento de servicios financieros tendrá una participación del 32,13% para 2032, impulsado por ventajas de los datos sintéticos como el intercambio seguro de datos y el desarrollo de modelos para la evaluación de riesgos, la detección de fraude y el análisis, sin exponer información real de los clientes. La generación de datos sintéticos también es posible para eventos poco frecuentes, como caídas del mercado o formas complejas de fraude, lo que ayuda a mejorar el rendimiento del modelo y a acelerar el desarrollo de la IA.
Análisis regional
¿Cuál es el panorama del mercado en América del Norte y en la región de Asia-Pacífico?
Según la región, el mercado global de generación de datos sintéticos se clasifica en América del Norte, Europa, Asia-Pacífico, Oriente Medio y África, y América del Sur.
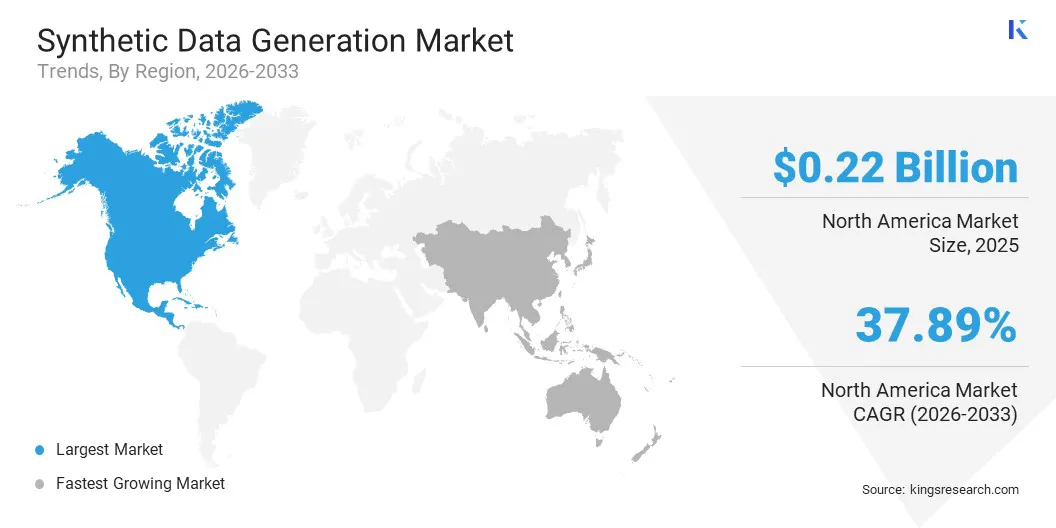
El mercado de generación de datos sintéticos de América del Norte representó una participación del 38,04% en 2025, valorada en USD 0,22 mil millones. Este predominio se atribuye a una combinación de infraestructura tecnológica avanzada y una mayor inversión en I+D en la región. En EE. UU., en particular, las empresas están adoptando las últimas tecnologías para reducir riesgos e ineficiencias.
Además, los consumidores prefieren apoyar a las marcas que se centran en innovaciones incrementales. En el comercio minorista, la generación de datos sintéticos ayuda a analizar las preferencias de los clientes, como los hábitos de compra y la demanda estacional, al tiempo que protege la privacidad. La región tiene obligaciones de privacidad de datos cada vez mayores y un sólido ecosistema de IA, lo que crea un entorno favorable para el crecimiento del mercado.
- En junio de 2021, CVEDIA anunció una solución para la brecha de adaptación de dominio mediante su flujo propio de datos sintéticos. Esto contribuye al desarrollo de la IA al permitir que los algoritmos entrenados con datos sintéticos rindan a la par de los entrenados con datos reales. CVEDIA afirmó haber logrado una mejora del 170% en precisión y una ganancia sostenida del 160% en exhaustividad (recall), en comparación con modelos de referencia.
El mercado de generación de datos sintéticos de Asia-Pacífico crecerá, según las previsiones, a una TCAC del 38,08% durante el período de previsión. Este notable crecimiento se apoya en el uso creciente de datos sintéticos en varios ámbitos de la región, como la salud y la manufactura, entre otros.
Por ejemplo, en el sector de la salud, los datos sintéticos se generan para crear historiales de pacientes realistas, lo que favorece la investigación y, a la vez, ofrece anonimización y agregación. Ayuda a los investigadores médicos a desarrollar y probar algoritmos de diagnóstico y tratamiento conforme a estrictas normas de protección de datos.
En la manufactura, las empresas automotrices usan datos sintéticos para simular numerosos escenarios de conducción para vehículos autónomos. Esto ayuda a entrenar modelos de aprendizaje automático para reconocer y responder a diversas condiciones sin necesidad de una amplia recopilación de datos reales. Empresas como Waymo y Tesla están transformando el uso de datos sintéticos para entrenar sus vehículos de conducción autónoma.
Marcos regulatorios
- El Reglamento General de Protección de Datos (RGPD) regula el tratamiento de datos personales en la UE y define qué se considera dato anonimizado o sintético.
- La Data (Use and Access) Act 2025 del Reino Unido regula las disposiciones sobre el tratamiento y el acceso a datos personales y comerciales. Actualiza el marco existente del RGPD del Reino Unido y la Data Protection Act.
- En Estados Unidos (California), la California Consumer Privacy Act (CCPA) y su enmienda, la California Privacy Rights Act (CPRA), rigen la recopilación y el uso de datos personales.
Panorama competitivo
Los actores clave del mercado de generación de datos sintéticos se centran principalmente en la innovación tecnológica continua. Existen numerosos actores pequeños y medianos que se enfocan en tipos de datos y sectores específicos. Los proveedores especializados no tienen una participación de mercado dominante y operan en segmentos de nicho.
Las grandes plataformas de nube e IA, como Microsoft y NVIDIA, entre otras, ocupan una posición clave en el mercado, ya que las capacidades de datos sintéticos están presentes dentro de servicios más amplios de IA y ML. También se pone énfasis en las asociaciones y adquisiciones para obtener ventajas estratégicas.
- En marzo de 2025, Nvidia adquirió Gretel, una startup de datos sintéticos, por más de USD 320 millones, lo que refuerza su conjunto de servicios de IA generativa para desarrolladores. Gretel mantiene alianzas con proveedores de nube importantes, como Google Cloud, Amazon Web Services y Microsoft.
Empresas clave del mercado de generación de datos sintéticos:
- MOSTLY AI
- Datagen
- CVEDIA Inc
- K2view Ltd.
- Microsoft Corporation
- GenRocket, Inc
- TonicAI, Inc.
- NVIDIA (Gretel Labs)
- CapGemini (Sogeti)
- MDClone
Novedades recientes (asociaciones)
- En abril de 2023, MDClone anunció que su plataforma ADAMS está impulsando un mayor número de alianzas entre organizaciones proveedoras de atención médica y empresas de ciencias de la vida para acelerar la investigación y el desarrollo terapéutico.
Preguntas frecuentes
¿Cuáles son los impulsores clave del mercado Generación de datos sintéticos?
¿Qué regiones son fundamentales para el crecimiento de la generación de datos sintéticos?
¿Qué desafíos enfrenta hoy la industria de generación de datos sintéticos?
¿Qué tendencias están dando forma al futuro de la generación de datos sintéticos?
¿Quiénes son los principales actores de este sector?
¿Qué oportunidades existen para los inversores?
¿Cómo me ayuda este informe a centrar nuestra estrategia de crecimiento en la región geográfica más prometedora?
¿Cómo me ayuda este informe a comprender qué categoría de DATOS tiene el mayor impacto económico?
Autor

Ashim Lakhera es un profesional de inteligencia de mercado especializado en la industria agrícola y de alimentos y bebidas. Su trabajo se centra en los mercados emergentes, la dinámica competitiva, las tendencias de la industria y los factores que impulsan el crecimiento y la transformación del mercado. Tiene experiencia en dimensionamiento de mercados, previsión, análisis estratégico e investigación industrial en alimentos, bienes de consumo y ciencias biológicas. Sus intereses de investigación abarcan la cadena de valor alimentaria y agrícola más amplia, con un enfoque particular en cómo la innovación, el cambio en el comportamiento del consumidor, las prioridades de sostenibilidad y la evolución de los sistemas de producción están influyendo en los mercados. Examina estos desarrollos para comprender su impacto en la demanda, la competencia, los modelos comerciales y las oportunidades de crecimiento en todo el ecosistema agroalimentario. Su trabajo combina el análisis cuantitativo del mercado con una comprensión de las fuerzas industriales más amplias que dan forma a los mercados alimentarios y agrícolas. Está particularmente interesado en los cambios estructurales que se están produciendo en los sistemas alimentarios mundiales y en cómo las empresas se están adaptando a las cambiantes expectativas de los consumidores, los avances tecnológicos y los requisitos de sostenibilidad.
Revisado por

Habi es un líder experimentado en investigación y consultoría con reconocida experiencia en guiar a clientes sobre iniciativas estratégicas de crecimiento y transformación en mercados globales. Ha dirigido equipos de investigación de alto rendimiento que brindan conocimientos prácticos sobre la expansión del mercado, estrategias de fusiones y adquisiciones, evaluación de oportunidades, desarrollo de nuevos negocios y lanzamientos de productos. Su cartera de proyectos abarca grandes productores petroquímicos, fabricantes de dispositivos electrónicos, empresas de lubricantes y otras empresas líderes en diversos sectores industriales y de consumo. Actualmente dirige el departamento de investigación de Kings Research, donde es responsable de establecer la agenda de investigación, asesorar a los analistas y garantizar resultados listos para el cliente que respalden la toma de decisiones ejecutivas. Con amplia experiencia en inteligencia de mercado, investigación estratégica y consultoría, Habi aporta un sólido conocimiento de la dinámica industrial en evolución, los panoramas competitivos, las oportunidades emergentes y los desafíos del crecimiento empresarial. Su experiencia incluye el desarrollo de marcos de investigación, la traducción de datos complejos del mercado en recomendaciones estratégicas viables y el trabajo en estrecha colaboración con partes interesadas de alto nivel para abordar cuestiones comerciales críticas. También ha contribuido a desarrollar capacidades de investigación, fortalecer metodologías analíticas e impulsar una cultura de calidad y toma de decisiones basada en conocimientos dentro de los equipos de investigación. Su exposición intersectorial le permite conectar las tendencias del mercado con implicaciones comerciales más amplias y brindar perspectivas que ayudan a las organizaciones a identificar oportunidades, mitigar riesgos y tomar decisiones estratégicas informadas.