


РЫНОК ГЕНЕРАЦИИ СИНТЕТИЧЕСКИХ ДАННЫХ (2026-2033)
Запросить сейчас
Определение рынка
Синтетические данные представляют собой искусственные данные, созданные для имитации реальных. Они генерируются искусственно, но сохраняют статистические свойства исходных данных, на основе которых были получены. Генерация синтетических данных может происходить в табличной, мультимедийной или текстовой форме. Синтетические текстовые данные могут быть полезны для обработки естественного языка (NLP). Аналогично, табличные данные находят применение при создании таблиц реляционных баз данных.
Синтетические мультимедийные данные включают изображения, видео и другие неструктурированные данные, которые могут иметь решающее значение для задач компьютерного зрения, таких как распознавание и классификация изображений, среди прочего. Требования к данным растут в таких секторах, как финансы, здравоохранение и розничная торговля. Синтетические данные помогают таким организациям ускорять инновации в области искусственного интеллекта (ИИ) и принимать более взвешенные решения.
Обзор рынка
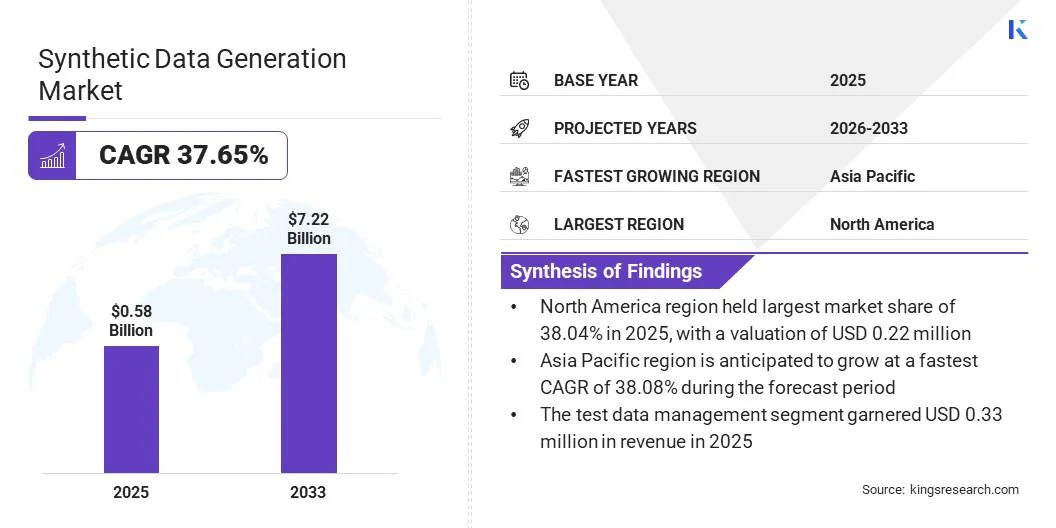
Объём мирового рынка генерации синтетических данных в 2025 году составил 0,58 млрд долларов США и, по прогнозам, вырастет с 0,77 млрд долларов США в 2026 году до 7,22 млрд долларов США к 2033 году при среднегодовом темпе роста (CAGR) 37,65% в течение прогнозируемого периода. Этот рост обусловлен применением синтетических данных для тестовых систем, обучения моделей ИИ и моделирования сценариев, которые обычно трудно воспроизвести на реальных данных.
Например, в здравоохранении синтетические медицинские записи могут отражать такие состояния, как диабет, заболевание или рак, что помогает разрабатывать и тестировать диагностические инструменты, а также прогностические модели здоровья.
Основными компаниями, работающими на мировом рынке генерации синтетических данных, являются MOSTLY AI, Datagen, TonicAI, Inc., GenRocket, Inc, NVIDIA (Gretel Labs), K2view Ltd., CapGemini (Sogeti), CVEDIA Inc, Microsoft Corporation и MDClone, а также другие.
Ожидается, что спрос на синтетические данные будет расти по мере их более широкого использования в различных секторах, включая автомобильный сектор, где они применяются для тестирования автономных транспортных средств, и здравоохранение, где они используются для анализа медицинских изображений и диагностики пациентов. В розничном секторе они в основном используются для управления инвестициями и анализа поведения клиентов.
Это может быть полезно в финансовой сфере для выявления мошенничества и оценки рисков. К ключевым преимуществам синтетических данных относятся экономическая эффективность, масштабируемость и разнообразие. Они широко используются при обучении моделей машинного обучения и обеспечивают больший контроль над качеством данных, а также сохраняют конфиденциальность за счёт отказа от использования реальных, чувствительных данных.
Актуальной тенденцией является интеграция федеративного обучения и дифференциальной приватности для усиления машинного обучения с сохранением конфиденциальности. Кроме того, спрос на разнообразные высококачественные обучающие наборы данных будет расти по мере распространения ИИ в новых областях, что делает синтетические данные крайне важными.
Ключевые моменты
- Объём мирового рынка генерации синтетических данных в 2025 году составил 0,58 млрд долларов США.
- Прогнозируется, что в период с 2026 по 2033 год рынок будет расти при CAGR 37,65%.
- В 2025 году доля Северной Америки составила 38,04%, что соответствует 0,22 млрд долларов США.
- Сегмент табличных данных принёс 0,20 млрд долларов США выручки в 2025 году.
- Ожидается, что сегмент управления тестовыми данными достигнет 4,05 млрд долларов США к 2033 году.
- Ожидается, что сегмент здравоохранения продемонстрирует самый высокий CAGR за прогнозируемый период, на уровне 38,28%.
- Ожидается, что Азиатско-Тихоокеанский регион будет расти при CAGR 38,08% в течение прогнозируемого периода.
Динамика рынка
Насколько надёжны синтетические данные для обучения ИИ?
Синтетические данные, созданные с использованием надёжных методов, могут не уступать реальным данным по эффективности модели, а в некоторых случаях и превосходить их, особенно в сценариях с редкими событиями.
Хотя синтетические данные не могут заменить реальные, они очень эффективны в качестве дополнения к ним, особенно когда команда сталкивается с ограниченными данными, несбалансированными наборами данных или ограничениями конфиденциальности. В результате они могут выступать мощным дополнением к реальным данным, а не их полной заменой.
- В октябре 2024 года MOSTLY AI представила новую функцию генерации синтетического текста для обучения моделей ИИ, которая также обеспечивает конфиденциальность собственных информационных активов. Она позволяет организациям использовать широкий спектр текстовых данных, таких как электронные письма, переписка с чат-ботами, стенограммы обращений в поддержку и т. п., для обучения и тонкой настройки больших языковых моделей (LLM), причём риск нарушения конфиденциальности отсутствует.
Почему при обучении систем ИИ важно учитывать, что синтетические данные могут приводить к ложным результатам?
Синтетическим данным может недоставать сложности и нюансов реальных данных, из-за чего модели ИИ могут хуже работать в реальных сценариях. Более того, модели ИИ, обученные исключительно на синтетических данных, могут неэффективно обобщаться на реальные ситуации из-за расхождений между синтетическими и фактическими данными. Это также может вызывать этические вопросы в некоторых сферах применения, например в медицинской диагностике.
Как генерация синтетических данных даёт бизнесу преимущества с точки зрения затрат и масштабируемости?
Сбор реальных данных обходится дорого и занимает много времени из-за развёртывания датчиков, разметки и обеспечения безопасности. Синтетические же данные для онлайнового машинного обучения можно легко генерировать быстрее и дешевле. Синтетические данные предоставляют контролируемые и масштабируемые источники данных для надёжной разработки ИИ. Например, такие организации, как Nvidia и Databricks, предлагают инструменты вроде Unity Catalog и Omniverse Replicator для автоматизации конвейеров синтетических данных. По оценкам, от 50% до 60% данных, используемых для обучения платформ ИИ, являются синтетическими. Спрос на них растёт, поскольку они помогают организациям моделировать новые продукты, ускорять разработку моделей ИИ и защищать конфиденциальную информацию.
- В октябре 2025 года GenRocket объявила о запуске Unstructured Data Accelerator (UDA), что позволило этой ориентированной на дизайн организации по генерации синтетических данных расширить свою платформу за пределы структурированных данных, охватив изображения, документы и файловые форматы. Это помогло организации генерировать данные любого типа безопасно, точно и в нужном масштабе по запросу.
Краткая сводка отчёта о рынке
|
Сегментация |
Подробности |
|
По типу данных |
Табличные данные, текстовые данные, данные изображений и видео, прочие |
|
По применению |
Управление тестовыми данными, обучение и разработка ИИ, корпоративный обмен данными, аналитика и визуализация данных |
|
По конечному пользователю |
Финансовые услуги, розничная торговля, здравоохранение и прочие |
|
По регионам |
Северная Америка: США, Канада, Мексика |
|
Европа: Франция, Великобритания, Испания, Германия, Италия, Россия, остальная Европа | |
|
Азиатско-Тихоокеанский регион: Китай, Япония, Индия, Австралия, АСЕАН, Южная Корея, остальной Азиатско-Тихоокеанский регион | |
|
Ближний Восток и Африка: Турция, ОАЭ, Саудовская Аравия, Южная Африка, остальной Ближний Восток и Африка | |
|
Южная Америка: Бразилия, Аргентина, остальная Южная Америка |
Сегментация рынка
- По типу данных (табличные данные, текстовые данные, данные изображений и видео и прочие): сегмент табличных данных принёс 0,20 млрд долларов США выручки в 2025 году, главным образом благодаря растущему внедрению в секторах электронной коммерции и здравоохранения. Такие данные широко используются для эффективного обучения ряда моделей машинного обучения.
- По применению (управление тестовыми данными, обучение и разработка ИИ, корпоративный обмен данными и аналитика и визуализация данных): сегмент обучения и разработки ИИ, по прогнозам, покажет впечатляющий CAGR 38,08% за прогнозируемый период благодаря широкой востребованности в обучении моделей машинного обучения. Он служит потенциальным решением для сценариев, где данные нужны, но качественных реальных данных для обучения моделей ИИ недостаточно.
- По конечному пользователю (финансовые услуги, розничная торговля, здравоохранение и прочие): ожидается, что к 2032 году доля сегмента финансовых услуг составит 32,13% благодаря таким преимуществам синтетических данных, как безопасный обмен данными и разработка моделей для оценки рисков, выявления мошенничества и аналитики без раскрытия реальной информации о клиентах. Генерация синтетических данных также возможна для редких событий, таких как обвалы рынка или сложные схемы мошенничества, что помогает повышать эффективность моделей и ускорять разработку ИИ.
Региональный анализ
Какова ситуация на рынке в Северной Америке и Азиатско-Тихоокеанском регионе?
По регионам мировой рынок генерации синтетических данных подразделяется на Северную Америку, Европу, Азиатско-Тихоокеанский регион, Ближний Восток и Африку, а также Южную Америку.
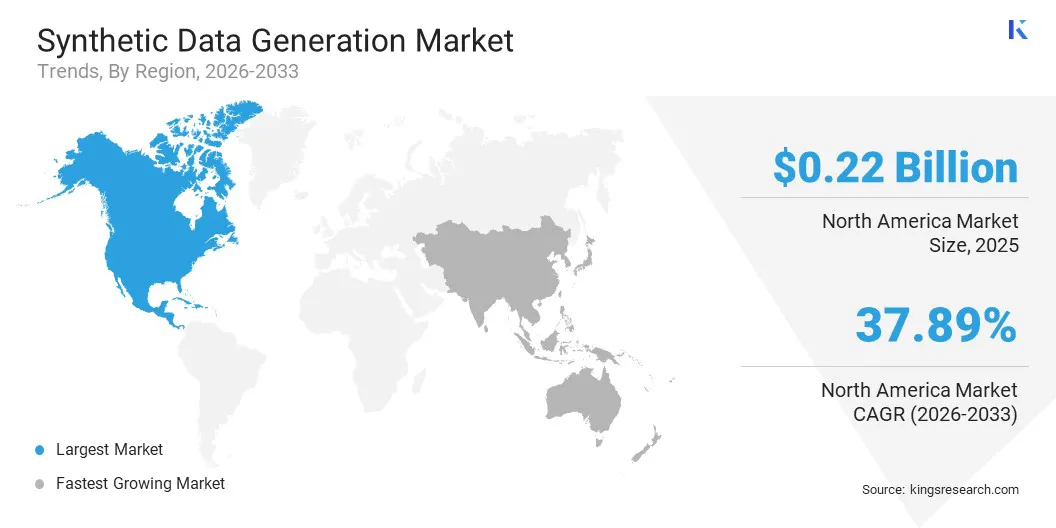
Рынок генерации синтетических данных Северной Америки занимал долю 38,04% в 2025 году, что соответствует 0,22 млрд долларов США. Такое доминирование обусловлено сочетанием передовой технологической инфраструктуры и роста инвестиций в НИОКР в регионе. В частности, в США компании внедряют новейшие технологии для снижения рисков и неэффективности.
Кроме того, потребители предпочитают поддерживать бренды, ориентированные на постепенные инновации. В розничной торговле генерация синтетических данных помогает анализировать предпочтения клиентов, такие как покупательские привычки и сезонный спрос, одновременно защищая конфиденциальность. В регионе растут требования к конфиденциальности данных и развивается сильная экосистема ИИ, что создаёт благоприятную среду для роста рынка.
- В июне 2021 года CVEDIA представила решение проблемы разрыва доменной адаптации на основе собственного конвейера синтетических данных. Оно способствует развитию ИИ, позволяя алгоритмам, обученным на синтетических данных, работать на уровне алгоритмов, обученных на реальных данных. CVEDIA заявила об улучшении точности на 170% и устойчивом приросте полноты на 160% по сравнению с эталонными моделями.
Рынок генерации синтетических данных Азиатско-Тихоокеанского региона, по прогнозам, будет расти при CAGR 38,08% в течение прогнозируемого периода. Этот заметный рост обеспечивается расширением использования синтетических данных в различных сферах региона, таких как здравоохранение, производство и другие.
Например, в здравоохранении синтетические данные генерируются для создания реалистичных записей пациентов, что способствует исследованиям и одновременно обеспечивает анонимизацию и агрегирование. Это помогает медицинским исследователям разрабатывать и тестировать алгоритмы для диагностики и лечения при соблюдении строгих норм защиты данных.
В производственном секторе автомобильные компании используют синтетические данные для моделирования различных сценариев вождения беспилотных автомобилей. Это помогает обучать модели машинного обучения распознавать различные условия и реагировать на них без необходимости масштабного сбора реальных данных. Такие компании, как Waymo и Tesla, совершают революцию в использовании синтетических данных для обучения своих беспилотных автомобилей.
Нормативно-правовая база
- Общий регламент по защите данных (GDPR) регулирует обработку персональных данных в ЕС и определяет, что квалифицируется как анонимизированные или синтетические данные.
- Закон Великобритании Data (Use and Access) Act 2025 («Закон о данных (использовании и доступе)») содержит положения, касающиеся обработки персональных и коммерческих данных и доступа к ним. Он обновляет действующую систему UK GDPR и Data Protection Act.
- В США (штат Калифорния) сбор и использование персональных данных регулируются Законом Калифорнии о конфиденциальности потребителей (CCPA) и поправкой к нему, Калифорнийским законом о правах на конфиденциальность (CPRA).
Конкурентная среда
Ключевые игроки рынка генерации синтетических данных в основном сосредоточены на непрерывных технологических инновациях. На рынке присутствует множество мелких и средних игроков, ориентированных на конкретные типы данных и секторы. Специализированные поставщики не занимают доминирующей доли рынка и работают в нишевых сегментах.
Крупные облачные и ИИ-платформы, такие как Microsoft и NVIDIA, среди прочих, занимают значительную долю рынка, поскольку возможности синтетических данных встроены в более широкие сервисы ИИ и ML. Кроме того, компании делают ставку на партнёрства и приобретения ради стратегических преимуществ.
- В марте 2025 года Nvidia приобрела Gretel, стартап в области синтетических данных, более чем за 320 млн долларов США, что укрепило её набор генеративных ИИ-сервисов для разработчиков. Gretel поддерживает партнёрства с крупными облачными провайдерами, такими как Google Cloud, Amazon Web Services и Microsoft.
Ключевые компании на рынке генерации синтетических данных:
- MOSTLY AI
- Datagen
- CVEDIA Inc
- K2view Ltd.
- Microsoft Corporation
- GenRocket, Inc
- TonicAI, Inc.
- NVIDIA (Gretel Labs)
- CapGemini (Sogeti)
- MDClone
Последние события (партнёрства)
- В апреле 2023 года MDClone объявила, что её платформа ADAMS обеспечивает рост числа партнёрств между организациями здравоохранения и компаниями в сфере медико-биологических наук для ускорения исследований и разработок в области терапии.
Часто задаваемые вопросы
Каковы ключевые факторы на рынке Генерация синтетических данных?
Какие регионы имеют решающее значение для роста производства синтетических данных?
С какими проблемами сегодня сталкивается индустрия генерации синтетических данных?
Какие тенденции формируют будущее генерации синтетических данных?
Кто является основными игроками в этом секторе?
Какие возможности существуют для инвесторов?
Как этот отчет поможет мне сосредоточить нашу стратегию роста на наиболее перспективном географическом регионе?
Как этот отчет поможет мне понять, какая категория ДАННЫХ оказывает наибольшее экономическое влияние?
Автор

Ашим Лахера — специалист по анализу рынка, специализирующийся на сельском хозяйстве и производстве продуктов питания и напитков. Его работа сосредоточена на развивающихся рынках, конкурентной динамике, тенденциях отрасли и факторах, способствующих росту и трансформации рынка. У него есть опыт определения размеров рынка, прогнозирования, стратегического анализа и отраслевых исследований в области продуктов питания, товаров повседневного спроса и наук о жизни. Его исследовательские интересы охватывают более широкую цепочку создания стоимости в области продуктов питания и сельского хозяйства, уделяя особое внимание тому, как инновации, изменение поведения потребителей, приоритеты устойчивого развития и развивающиеся производственные системы влияют на рынки. Он изучает эти события, чтобы понять их влияние на спрос, конкуренцию, бизнес-модели и возможности роста в агропродовольственной экосистеме. Его работа сочетает количественный анализ рынка с пониманием более широких отраслевых сил, формирующих рынки продуктов питания и сельского хозяйства. Его особенно интересуют структурные изменения, происходящие в глобальных продовольственных системах, и то, как предприятия адаптируются к меняющимся ожиданиям потребителей, технологическим разработкам и требованиям устойчивого развития.
Проверено

Хаби — опытный руководитель исследований и консалтинга с известным опытом консультирования клиентов по инициативам стратегического роста и трансформации на мировых рынках. Он возглавлял высокопроизводительные исследовательские группы, которые предоставляют действенную информацию о расширении рынка, стратегиях слияний и поглощений, оценке возможностей, развитии нового бизнеса и запуске продуктов. В его портфолио проектов входят крупные нефтехимические производители, производители электронного оборудования, компании по производству смазочных материалов и другие ведущие предприятия в различных промышленных и потребительских секторах. В настоящее время он возглавляет исследовательский отдел Kings Research, где отвечает за разработку программы исследований, наставничество для аналитиков и обеспечение готовых к использованию результатов для клиентов, которые поддерживают принятие решений руководителями. Обладая обширным опытом в области анализа рынка, стратегических исследований и консалтинга, Хаби хорошо понимает развивающуюся динамику отрасли, конкурентную среду, новые возможности и проблемы роста бизнеса. Его опыт включает разработку исследовательских рамок, преобразование сложных рыночных данных в практические стратегические рекомендации, а также тесное сотрудничество со старшими заинтересованными сторонами для решения важнейших бизнес-вопросов. Он также внес свой вклад в создание исследовательских возможностей, укрепление аналитических методологий и развитие культуры принятия решений на основе качества и знаний в исследовательских группах. Его межотраслевые знания позволяют ему связывать рыночные тенденции с более широкими последствиями для бизнеса и предлагать перспективы, которые помогают организациям выявлять возможности, снижать риски и принимать обоснованные стратегические решения.