


MERCADO DE GERAÇÃO DE DADOS SINTÉTICOS (2026-2033)
Pergunte agora
Definição de Mercado
Dados sintéticos são dados artificiais projetados para imitar dados do mundo real. Eles são gerados artificialmente, mas mantêm as propriedades estatísticas dos dados originais a partir dos quais foram gerados. A geração de dados sintéticos pode ocorrer em formato tabular, multimídia ou de texto. Dados de texto sintéticos podem ser úteis para o processamento de linguagem natural (NLP). Da mesma forma, os dados tabulares têm aplicações na criação de tabelas de bancos de dados relacionais.
A multimídia sintética inclui imagens, vídeos e outros dados não estruturados, que podem ser cruciais para tarefas de visão computacional, como reconhecimento e classificação de imagens, entre outras. Há requisitos crescentes de dados em setores como finanças, saúde e varejo. Os dados sintéticos estão ajudando essas organizações a acelerar a inovação em IA e a tomar decisões mais inteligentes.
Visão Geral do Mercado
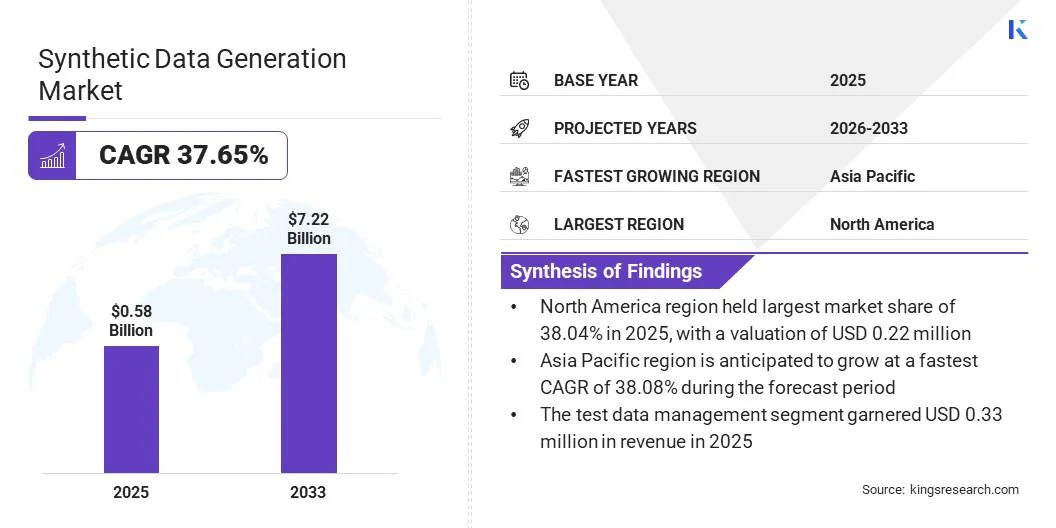
O tamanho do mercado global de geração de dados sintéticos foi avaliado em US$ 0,58 bilhão em 2025 e deve crescer de US$ 0,77 bilhão em 2026 para US$ 7,22 bilhões até 2033, com um CAGR de 37,65% durante o período de previsão. Esse crescimento é atribuído à sua aplicação em sistemas de teste, no treinamento de modelos de IA e na simulação de cenários, algo geralmente difícil de captar em dados reais.
Por exemplo, no setor de saúde, registros médicos sintéticos podem indicar condições como diabetes, doença ou câncer, o que pode ajudar a desenvolver e testar ferramentas de diagnóstico, além de modelos preditivos de saúde.
As principais empresas que atuam no mercado global de geração de dados sintéticos são MOSTLY AI, Datagen, TonicAI, Inc., GenRocket, Inc, NVIDIA (Gretel Labs), K2view Ltd., CapGemini (Sogeti), CVEDIA Inc, Microsoft Corporation e MDClone, entre outras.
Espera-se que a demanda por dados sintéticos cresça com seu uso crescente em vários setores, incluindo o setor automotivo para o teste de veículos autônomos, a saúde para análise de imagens médicas e diagnóstico de pacientes. No setor de varejo, é amplamente usado para gestão de investimentos e análise do comportamento do cliente.
Pode ser benéfico em finanças para detecção de fraudes e avaliação de risco. A principal vantagem dos dados sintéticos inclui custo-benefício, escalabilidade e diversidade. Eles são amplamente usados no treinamento de modelos de aprendizado de máquina. Isso oferece maior controle sobre a qualidade dos dados e também preserva a privacidade ao eliminar o uso de dados reais e sensíveis.
A tendência recente indica a integração do aprendizado federado e da privacidade diferencial para aprimorar o aprendizado de máquina que preserva a privacidade. Além disso, a demanda por conjuntos de dados de treinamento diversos e de alta qualidade crescerá com a expansão da IA em novos domínios, tornando os dados sintéticos muito importantes.
Principais Destaques
- O tamanho do mercado global de geração de dados sintéticos foi registrado em US$ 0,58 bilhão em 2025.
- Prevê-se que o mercado cresça a um CAGR de 37,65% de 2026 a 2033.
- A América do Norte deteve uma participação de 38,04% em 2025, avaliada em US$ 0,22 bilhão.
- O segmento de dados tabulares obteve US$ 0,20 bilhão em receita em 2025.
- Espera-se que o segmento de gerenciamento de dados de teste atinja US$ 4,05 bilhões até 2033.
- Prevê-se que o segmento de saúde registre o CAGR mais rápido, de 38,28%, ao longo do período de previsão.
- Prevê-se que a Ásia-Pacífico cresça a um CAGR de 38,08% ao longo do período de projeção.
Dinâmica de Mercado
Quão confiáveis são os dados sintéticos para o treinamento de IA?
Os dados sintéticos, quando gerados com técnicas robustas, podem igualar ou, em alguns casos, superar os dados reais no desempenho do modelo, principalmente em cenários de eventos raros.
Embora não possam substituir os dados reais, os dados sintéticos são muito eficazes para complementá-los, principalmente quando a equipe lida com dados limitados, conjuntos de dados desequilibrados ou restrições de privacidade. Como resultado, podem funcionar como um complemento poderoso aos dados reais, em vez de um substituto completo.
- Em outubro de 2024, a MOSTLY AI revelou sua nova funcionalidade de texto sintético para o treinamento de modelos de IA, cuidando também da privacidade de ativos de dados proprietários. Isso ajuda a organização a usar uma ampla gama de dados de texto, como e-mails, conversas de chatbot e transcrições de suporte ao cliente, para o treinamento e o ajuste fino dos grandes modelos de linguagem (LLMs), sem nenhum risco de violação de privacidade.
Por que o treinamento de sistemas de IA exige a consciência de que os dados sintéticos podem gerar resultados falsos?
Os dados sintéticos podem carecer da complexidade e das nuances dos dados do mundo real, o que pode fazer com que os modelos de IA tenham desempenho insatisfatório em cenários reais. Além disso, há a possibilidade de que modelos de IA totalmente treinados com dados sintéticos não consigam generalizar de forma eficaz para situações do mundo real, devido às disparidades entre dados sintéticos e reais. Isso também pode levantar preocupações éticas em algumas aplicações, como o diagnóstico médico.
Como a geração de dados sintéticos oferece vantagens comerciais em termos de custo e escalabilidade?
A coleta de dados reais é cara e lenta, envolvendo a implantação de sensores, a rotulagem e a segurança. Já os dados sintéticos para o aprendizado de máquina on-line podem ser gerados de forma mais barata e rápida. Os dados sintéticos oferecem fontes de dados controladas e escaláveis para o desenvolvimento robusto da IA. Por exemplo, organizações como a Nvidia e a Databricks oferecem ferramentas como Unity Catalog e Omniverse Replicator para automatizar pipelines de dados sintéticos. Estima-se que cerca de 50% a 60% dos dados usados para treinar plataformas de IA sejam sintéticos. Sua demanda está aumentando à medida que esses dados ajudam as organizações a simular novos produtos, acelerar o desenvolvimento de modelos de IA e proteger informações sensíveis.
- Em outubro de 2025, a GenRocket anunciou o lançamento de seu Unstructured Data Accelerator (UDA), o que levou a organização de geração de dados sintéticos orientada a design a expandir sua plataforma além dos dados estruturados, chegando a imagens, documentos e formatos baseados em arquivos. Isso ajudou a organização a gerar qualquer forma de dados com segurança, com precisão e em escala, sob demanda.
Panorama do Relatório de Mercado
|
Segmentação |
Detalhes |
|
Por Tipo de Dados |
Dados Tabulares, Dados de Texto, Dados de Imagem e Vídeo, Outros |
|
Por Aplicação |
Gerenciamento de Dados de Teste, Treinamento e Desenvolvimento de IA, Compartilhamento de Dados Empresariais, Análise e Visualização de Dados |
|
Por Usuário Final |
Serviços Financeiros, Varejo, Saúde e Outros |
|
Por Região |
América do Norte: EUA, Canadá, México |
|
Europa: França, Reino Unido, Espanha, Alemanha, Itália, Rússia, Resto da Europa | |
|
Ásia-Pacífico: China, Japão, Índia, Austrália, ASEAN, Coreia do Sul, Resto da Ásia-Pacífico | |
|
Oriente Médio e África: Turquia, EAU, Arábia Saudita, África do Sul, Resto do Oriente Médio e África | |
|
América do Sul: Brasil, Argentina, Resto da América do Sul |
Segmentação de Mercado
- Por tipo de dados (Dados Tabulares, Dados de Texto, Dados de Imagem e Vídeo e Outros): O segmento de dados tabulares gerou US$ 0,20 bilhão em receita em 2025, principalmente devido à sua crescente adoção nos setores de comércio eletrônico e saúde. É amplamente usado para treinar com eficácia alguns modelos de aprendizado de máquina.
- Por aplicação (Gerenciamento de Dados de Teste, Treinamento e Desenvolvimento de IA, Compartilhamento de Dados Empresariais e Análise e Visualização de Dados): O segmento de treinamento e desenvolvimento de IA deve registrar um CAGR impressionante de 38,08% ao longo do período de previsão, impulsionado por sua ampla necessidade no treinamento de modelos de aprendizado de máquina. Ele está servindo como uma solução potencial para cenários em que há necessidade de dados, mas há uma oferta escassa de dados reais de alta qualidade para o treinamento de modelos de IA.
- Por usuário final (Serviços Financeiros, Varejo, Saúde e Outros): Estima-se que o segmento de serviços financeiros detenha uma participação de 32,13% até 2032, impulsionado pelas vantagens dos dados sintéticos, como o compartilhamento seguro de dados e o desenvolvimento de modelos para avaliação de risco, detecção de fraude e análise, sem expor as informações reais do cliente. É possível gerar dados sintéticos para eventos raros, como quebras de mercado ou formas complexas de fraude, o que ajuda a melhorar o desempenho do modelo e a acelerar o desenvolvimento da IA.
Análise Regional
Qual é o cenário de mercado na América do Norte e na região Ásia-Pacífico?
Com base na região, o mercado global de geração de dados sintéticos foi classificado em América do Norte, Europa, Ásia-Pacífico, Oriente Médio e África, e América do Sul.
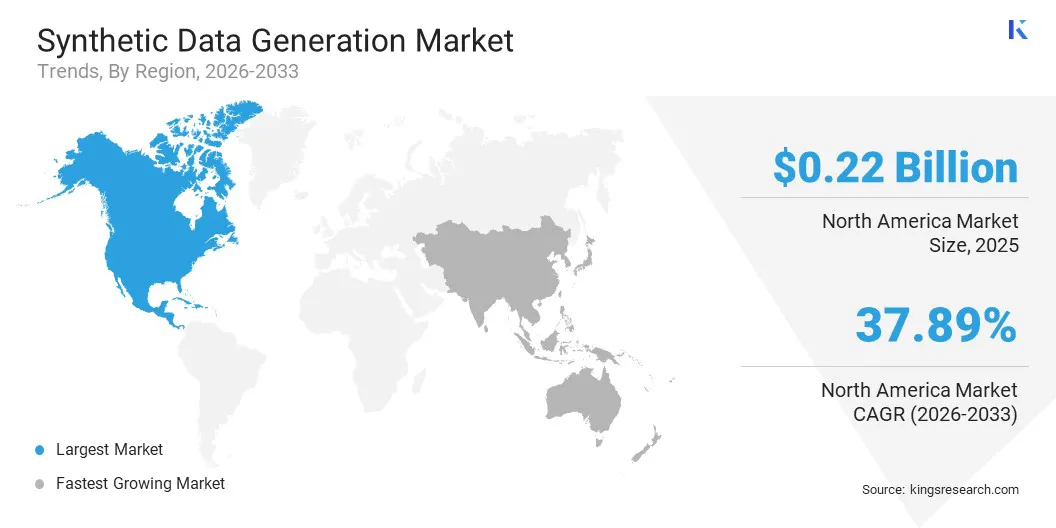
O mercado de geração de dados sintéticos da América do Norte respondeu por uma participação de 38,04% em 2025, avaliado em US$ 0,22 bilhão. Esse domínio é atribuído a uma combinação de infraestrutura tecnológica avançada e maior investimento em P&D na região. Nos EUA, em particular, as empresas estão adotando as tecnologias mais recentes para reduzir riscos e ineficiências.
Além disso, os consumidores preferem apoiar marcas que se concentrem em inovações incrementais. No varejo, a geração de dados sintéticos está ajudando a analisar preferências dos clientes, como hábitos de compra e demanda sazonal, ao mesmo tempo que protege a privacidade. A região tem obrigações crescentes de privacidade de dados e um forte ecossistema de IA, o que está criando um ambiente favorável para o crescimento do mercado.
- Em junho de 2021, a CVEDIA anunciou uma solução para a lacuna de adaptação de domínio usando seu pipeline proprietário de dados sintéticos. Isso pode ajudar no desenvolvimento da IA, permitindo que algoritmos treinados com dados sintéticos tenham desempenho equivalente aos treinados com dados reais. A CVEDIA afirmou ter obtido uma melhoria de precisão de 170% e um ganho sustentado de 160% no recall em comparação com modelos de referência.
O mercado de geração de dados sintéticos da Ásia-Pacífico deve crescer a um CAGR de 38,08% ao longo do período de previsão. Esse crescimento notável é sustentado pelo uso crescente de dados sintéticos em vários setores da região, como saúde, manufatura, entre outros.
Por exemplo, na área da saúde, os dados sintéticos são gerados para criar registros de pacientes realistas, que ajudam a pesquisa e, ao mesmo tempo, oferecem anonimização e agregação. Isso ajuda pesquisadores médicos a desenvolver e testar algoritmos para diagnóstico e tratamento, seguindo rígidas regulamentações de proteção de dados.
Na manufatura, as montadoras estão usando dados sintéticos para simular diversos cenários de condução para carros autônomos. Isso ajuda no treinamento de modelos de aprendizado de máquina para reconhecer e responder a várias condições, sem a necessidade de uma extensa coleta de dados do mundo real. Empresas como Waymo e Tesla estão revolucionando o uso de dados sintéticos para treinar seus carros autônomos.
Estruturas Regulatórias
- O Regulamento Geral de Proteção de Dados (GDPR) controla o processamento de dados pessoais na UE e define o que se qualifica como dados anonimizados ou sintéticos.
- No Reino Unido, o Data (Use and Access) Act 2025 (Lei de Uso e Acesso a Dados) trata das disposições relativas ao processamento e ao acesso de dados pessoais e empresariais. Ele atualiza a estrutura existente do UK GDPR e do Data Protection Act.
- Nos Estados Unidos (Califórnia), a Lei de Privacidade do Consumidor da Califórnia (CCPA) e sua emenda, a Lei de Direitos de Privacidade da Califórnia (CPRA), regem a coleta e o uso de dados pessoais.
Panorama Competitivo
Os principais players do mercado de geração de dados sintéticos estão focados principalmente na inovação tecnológica contínua. Há muitos players pequenos e de médio porte que visam tipos de dados e setores específicos. Os fornecedores especializados não detêm uma participação dominante no mercado e operam em segmentos de nicho.
Grandes plataformas de nuvem e IA, como Microsoft e NVIDIA, entre outras, detêm uma parcela importante do mercado, já que os recursos de dados sintéticos estão presentes em serviços mais amplos de IA e ML. O foco também está em parcerias e aquisições para obter vantagens estratégicas.
- Em março de 2025, a Nvidia adquiriu a Gretel, uma startup de dados sintéticos, por mais de US$ 320 milhões, o que está fortalecendo seu conjunto de serviços de IA generativa para desenvolvedores. A Gretel mantém parcerias com grandes provedores de nuvem, como Google Cloud, Amazon Web Services e Microsoft.
Principais Empresas no Mercado de Geração de Dados Sintéticos:
- MOSTLY AI
- Datagen
- CVEDIA Inc
- K2view Ltd.
- Microsoft Corporation
- GenRocket, Inc
- TonicAI, Inc.
- NVIDIA (Gretel Labs)
- CapGemini (Sogeti)
- MDClone
Desenvolvimentos Recentes (Parcerias)
- Em abril de 2023, a MDClone anunciou que sua plataforma ADAMS está viabilizando um número maior de parcerias entre organizações prestadoras de serviços de saúde e empresas de ciências da vida, para acelerar a pesquisa e o desenvolvimento terapêutico.
Perguntas frequentes
Quais são os principais impulsionadores do mercado de geração de dados sintéticos?
Quais regiões são centrais para o crescimento da geração de dados sintéticos?
Que desafios a indústria de geração de dados sintéticos enfrenta hoje?
Que tendências estão moldando o futuro da geração de dados sintéticos?
Quem são os principais players deste setor?
Que oportunidades existem para investidores?
Como é que este relatório me ajuda a concentrar a nossa estratégia de crescimento na região geográfica mais promissora?
Como este relatório me ajuda a entender qual categoria de DADOS tem o maior impacto econômico?
Autor

Ashim Lakhera é um profissional de inteligência de mercado especializado na indústria agrícola e de alimentos e bebidas. Seu trabalho se concentra nos mercados emergentes, na dinâmica competitiva, nas tendências do setor e nos fatores que impulsionam o crescimento e a transformação do mercado. Ele tem experiência em dimensionamento de mercado, previsão, análise estratégica e pesquisa do setor de alimentos, FMCG e ciências biológicas. Os seus interesses de investigação abrangem a cadeia de valor mais ampla da alimentação e da agricultura, com especial enfoque na forma como a inovação, a mudança do comportamento do consumidor, as prioridades de sustentabilidade e a evolução dos sistemas de produção estão a influenciar os mercados. Ele examina esses desenvolvimentos para compreender seu impacto na demanda, na concorrência, nos modelos de negócios e nas oportunidades de crescimento em todo o ecossistema agroalimentar. O seu trabalho combina a análise quantitativa do mercado com uma compreensão das forças industriais mais amplas que moldam os mercados alimentares e agrícolas. Ele está particularmente interessado nas mudanças estruturais que ocorrem nos sistemas alimentares globais e em como as empresas estão se adaptando à evolução das expectativas dos consumidores, aos desenvolvimentos tecnológicos e aos requisitos de sustentabilidade.
Revisado por

Habi é um líder experiente em pesquisa e consultoria, com experiência renomada em orientar clientes em iniciativas estratégicas de crescimento e transformação em mercados globais. Ele liderou equipes de pesquisa de alto desempenho que fornecem insights práticos sobre expansão de mercado, estratégias de fusões e aquisições, avaliação de oportunidades, desenvolvimento de novos negócios e lançamentos de produtos. Seu portfólio de projetos abrange grandes produtores petroquímicos, fabricantes de dispositivos eletrônicos, empresas de lubrificantes e outras empresas líderes em diversos setores industriais e de consumo. Atualmente, ele chefia o departamento de pesquisa da Kings Research, onde é responsável por definir a agenda de pesquisa, orientar analistas e garantir resultados prontos para o cliente que apoiem a tomada de decisões executivas. Com ampla experiência em inteligência de mercado, pesquisa estratégica e consultoria, Habi traz uma forte compreensão da evolução da dinâmica da indústria, dos cenários competitivos, das oportunidades emergentes e dos desafios de crescimento dos negócios. Sua experiência inclui o desenvolvimento de estruturas de pesquisa, a tradução de dados complexos de mercado em recomendações estratégicas viáveis e o trabalho em estreita colaboração com as partes interessadas seniores para abordar questões críticas de negócios. Ele também contribuiu para a construção de capacidades de pesquisa, fortalecendo metodologias analíticas e impulsionando uma cultura de qualidade e tomada de decisão baseada em insights dentro das equipes de pesquisa. Sua exposição intersetorial permite-lhe conectar tendências de mercado com implicações comerciais mais amplas e fornecer perspectivas que ajudam as organizações a identificar oportunidades, mitigar riscos e tomar decisões estratégicas informadas.