


MARCHÉ DE LA GÉNÉRATION DE DONNÉES SYNTHÉTIQUES (2026-2033)
Renseignez-vous maintenant
Définition du marché
Les données synthétiques sont des données artificielles conçues pour imiter des données réelles. Elles sont générées artificiellement mais conservent les propriétés statistiques des données d’origine à partir desquelles elles ont été générées. La génération de données synthétiques peut se faire sous forme tabulaire, multimédia ou textuelle. Les données textuelles synthétiques peuvent être utiles pour le traitement du langage naturel (NLP). De même, les données tabulaires trouvent des applications dans la création de tables de bases de données relationnelles.
Le multimédia synthétique comprend des images, des vidéos et d’autres données non structurées, qui peuvent être essentielles pour des tâches de vision par ordinateur telles que la reconnaissance et la classification d’images, entre autres. Les besoins en données augmentent dans des secteurs tels que la finance, la santé et le commerce de détail. Les données synthétiques aident ces organisations en accélérant l’innovation en IA et en permettant des décisions plus intelligentes.
Aperçu du marché
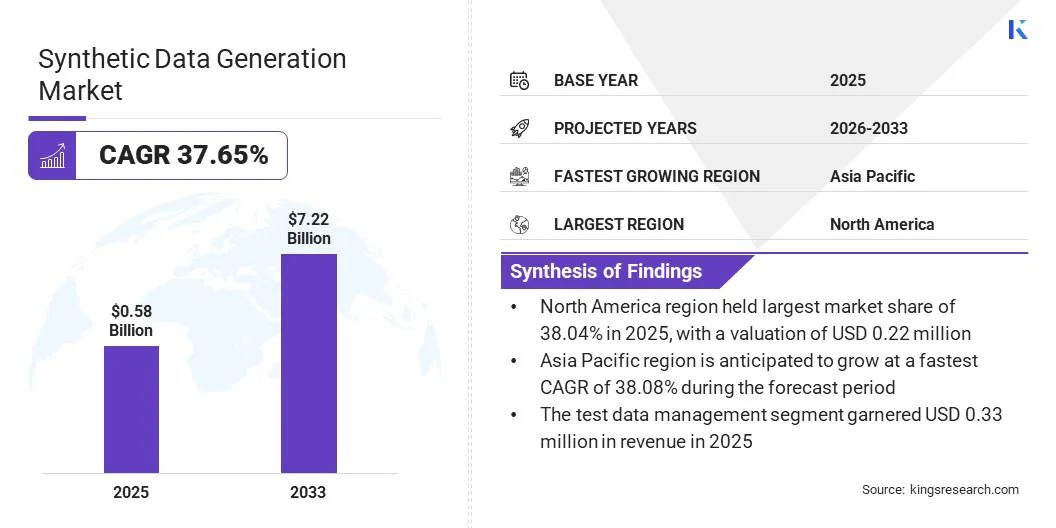
La taille du marché mondial de la génération de données synthétiques était évaluée à 0,58 milliard USD en 2025 et devrait passer de 0,77 milliard USD en 2026 à 7,22 milliards USD d’ici 2033, avec un TCAC de 37,65 % au cours de la période de prévision. Cette croissance est attribuée à son utilisation pour les systèmes de test, l’entraînement des modèles d’IA et la simulation de scénarios, généralement difficiles à saisir dans des données réelles.
Par exemple, dans le secteur de la santé, les dossiers médicaux synthétiques peuvent représenter des affections telles que le diabète, une maladie ou le cancer, ce qui peut aider à développer et à tester des outils de diagnostic ainsi que des modèles de santé prédictifs.
Les principales entreprises opérant sur le marché mondial de la génération de données synthétiques sont MOSTLY AI, Datagen, TonicAI, Inc., GenRocket, Inc, NVIDIA (Gretel Labs), K2view Ltd., CapGemini (Sogeti), CVEDIA Inc, Microsoft Corporation et MDClone, entre autres.
La demande de données synthétiques devrait croître avec leur utilisation grandissante dans plusieurs secteurs, notamment le secteur automobile pour les essais de véhicules autonomes, la santé pour l’analyse d’imagerie médicale et le diagnostic des patients. Dans le secteur du commerce de détail, elles sont largement utilisées pour la gestion des investissements et l’analyse du comportement des clients.
Cela peut être bénéfique en finance pour la détection des fraudes et l’évaluation des risques. Les principaux avantages des données synthétiques sont la rentabilité, l’évolutivité et la diversité. Elles sont largement utilisées pour l’entraînement des modèles d’apprentissage automatique. Elles offrent un meilleur contrôle sur la qualité des données et préservent également la confidentialité en évitant le recours à des données réelles et sensibles.
La tendance récente indique l’intégration de l’apprentissage fédéré et de la confidentialité différentielle pour renforcer l’apprentissage automatique préservant la confidentialité. Par ailleurs, la demande de jeux de données d’entraînement diversifiés et de haute qualité augmentera avec l’expansion de l’IA dans de nouveaux domaines, rendant les données synthétiques très importantes.
Points clés
- La taille du marché mondial de la génération de données synthétiques a été estimée à 0,58 milliard USD en 2025.
- Le marché devrait croître à un TCAC de 37,65 % entre 2026 et 2033.
- L’Amérique du Nord détenait une part de 38,04 % en 2025, évaluée à 0,22 milliard USD.
- Le segment des données tabulaires a généré un chiffre d’affaires de 0,20 milliard USD en 2025.
- Le segment de la gestion des données de test devrait atteindre 4,05 milliards USD d’ici 2033.
- Le segment de la santé devrait connaître le TCAC le plus élevé, à 38,28 %, au cours de la période de prévision.
- L’Asie-Pacifique devrait croître à un TCAC de 38,08 % au cours de la période de projection.
Dynamique du marché
Dans quelle mesure les données synthétiques sont-elles fiables pour l’entraînement de l’IA ?
Les données synthétiques, lorsqu’elles sont générées avec des techniques robustes, peuvent égaler ou, dans certains cas, surpasser les données réelles en matière de performance des modèles, en particulier dans les scénarios d’événements rares.
Bien qu’elles ne puissent pas remplacer les données réelles, elles sont très efficaces en complément de celles-ci, notamment lorsque l’équipe fait face à des données limitées, des jeux de données déséquilibrés ou des contraintes de confidentialité. Elles peuvent ainsi constituer un complément puissant aux données réelles plutôt qu’un remplacement complet.
- En octobre 2024, MOSTLY AI a dévoilé sa nouvelle fonctionnalité de texte synthétique pour l’entraînement des modèles d’IA, qui protège également la confidentialité des actifs de données propriétaires. Elle aide les organisations à utiliser un large éventail de données textuelles telles que les e-mails, les conversations de chatbot et les transcriptions du support client, entre autres, pour l’entraînement et l’affinage des grands modèles de langage (LLM), sans aucun risque de violation de la confidentialité.
Pourquoi l’entraînement des systèmes d’IA nécessite-t-il d’être conscient que les données synthétiques peuvent produire des résultats erronés ?
Les données synthétiques peuvent manquer de la complexité et des nuances des données réelles, ce qui peut amener les modèles d’IA à donner de mauvais résultats dans des scénarios réels. De plus, il est possible que des modèles d’IA entièrement entraînés sur des données synthétiques ne parviennent pas à généraliser efficacement à des situations réelles, en raison des écarts entre données synthétiques et données réelles. Cela pourrait également soulever des préoccupations éthiques dans certaines applications, telles que le diagnostic médical.
Comment la génération de données synthétiques offre-t-elle des avantages commerciaux en termes de coût et d’évolutivité ?
La collecte de données réelles est coûteuse et lente, en raison du déploiement de capteurs, de l’étiquetage et de la sécurité. Mais les données synthétiques destinées à l’apprentissage automatique en ligne peuvent être générées plus facilement, à moindre coût et plus rapidement. Les données synthétiques offrent des sources de données contrôlées et évolutives pour un développement robuste de l’IA. Par exemple, des organisations telles que Nvidia et Databricks proposent des outils tels qu’Unity Catalog et Omniverse Replicator pour automatiser les pipelines de données synthétiques. On estime qu’environ 50 à 60 % des données utilisées pour l’entraînement des plateformes d’IA sont synthétiques. La demande en données synthétiques augmente car elles aident les organisations à simuler de nouveaux produits, à accélérer le développement de modèles d’IA et à protéger les informations sensibles.
- En octobre 2025, GenRocket a annoncé le lancement de son Unstructured Data Accelerator (UDA), ce qui a permis à cette organisation spécialisée dans la génération de données synthétiques pilotée par la conception d’étendre sa plateforme au-delà des données structurées vers les images, les documents et les formats basés sur des fichiers. Cela a aidé l’organisation à générer toute forme de données de manière sûre, précise et à grande échelle, à la demande.
Aperçu du rapport sur le marché
|
Segmentation |
Détails |
|
Par type de données |
Données tabulaires, données textuelles, données d’image et de vidéo, autres |
|
Par application |
Gestion des données de test, entraînement et développement de l’IA, partage de données d’entreprise, analyse et visualisation de données |
|
Par utilisateur final |
Services financiers, commerce de détail, santé et autres |
|
Par région |
Amérique du Nord : États-Unis, Canada, Mexique |
|
Europe : France, Royaume-Uni, Espagne, Allemagne, Italie, Russie, reste de l’Europe | |
|
Asie-Pacifique : Chine, Japon, Inde, Australie, ASEAN, Corée du Sud, reste de l’Asie-Pacifique | |
|
Moyen-Orient et Afrique : Turquie, Émirats arabes unis, Arabie saoudite, Afrique du Sud, reste du Moyen-Orient et de l’Afrique | |
|
Amérique du Sud : Brésil, Argentine, reste de l’Amérique du Sud |
Segmentation du marché
- Par type de données (données tabulaires, données textuelles, données d’image et de vidéo, et autres) : le segment des données tabulaires a généré un chiffre d’affaires de 0,20 milliard USD en 2025, principalement en raison de son adoption croissante dans les secteurs du e-commerce et de la santé. Il est largement utilisé pour entraîner efficacement certains modèles d’apprentissage automatique.
- Par application (gestion des données de test, entraînement et développement de l’IA, partage de données d’entreprise, et analyse et visualisation de données) : le segment entraînement et développement de l’IA devrait enregistrer un TCAC impressionnant de 38,08 % au cours de la période de prévision, porté par la forte demande dont il fait l’objet pour l’entraînement des modèles d’apprentissage automatique. Il constitue une solution potentielle pour les scénarios où des données sont nécessaires, mais où l’offre de données réelles de haute qualité pour l’entraînement des modèles d’IA est limitée.
- Par utilisateur final (services financiers, commerce de détail, santé, et autres) : le segment des services financiers devrait détenir une part de 32,13 % d’ici 2032, porté par les avantages des données synthétiques tels que le partage sécurisé des données et le développement de modèles pour l’évaluation des risques, la détection des fraudes et l’analyse, sans exposer les informations réelles des clients. La génération de données synthétiques permet de couvrir des événements rares tels que les krachs boursiers ou des formes complexes de fraude, ce qui contribue à améliorer la performance des modèles et à accélérer le développement de l’IA.
Analyse régionale
Quel est le scénario de marché en Amérique du Nord et dans la région Asie-Pacifique ?
Selon la région, le marché mondial de la génération de données synthétiques a été classé en Amérique du Nord, Europe, Asie-Pacifique, Moyen-Orient et Afrique, et Amérique du Sud.
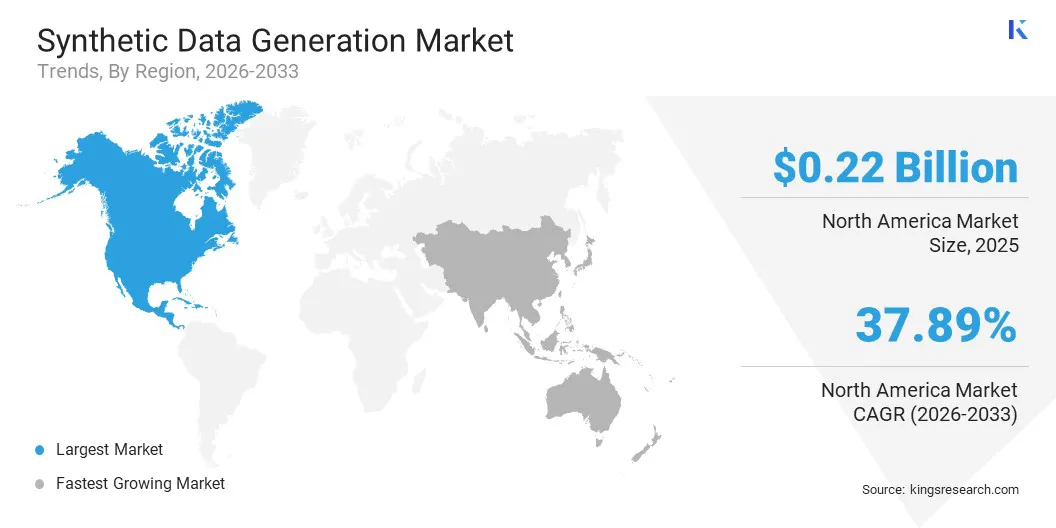
Le marché nord-américain de la génération de données synthétiques représentait une part de 38,04 % en 2025, évaluée à 0,22 milliard USD. Cette domination est attribuée à une combinaison d’infrastructures technologiques avancées et d’investissements accrus en R&D dans la région. Aux États-Unis en particulier, les entreprises adoptent les dernières technologies pour réduire les risques et l’inefficacité.
Par ailleurs, les consommateurs préfèrent soutenir les marques qui misent sur les innovations incrémentales. Dans le commerce de détail, la génération de données synthétiques aide à analyser les préférences des clients, telles que les habitudes d’achat et la demande saisonnière, tout en protégeant la confidentialité. La région connaît des obligations croissantes en matière de confidentialité des données et dispose d’un écosystème d’IA solide, ce qui crée un environnement favorable à la croissance du marché.
- En juin 2021, CVEDIA a annoncé une solution pour combler l’écart d’adaptation de domaine à l’aide de son pipeline de données synthétiques propriétaire. Ces solutions peuvent contribuer au développement de l’IA en permettant à des algorithmes entraînés sur des données synthétiques de fonctionner au même niveau que ceux entraînés sur des données réelles. CVEDIA revendique une amélioration de la précision de 170 % et un gain de rappel soutenu de 160 % par rapport à des modèles de référence.
Le marché de la génération de données synthétiques en Asie-Pacifique devrait croître à un TCAC de 38,08 % au cours de la période de prévision. Cette croissance notable est soutenue par l’utilisation croissante des données synthétiques dans plusieurs domaines de la région, tels que la santé, l’industrie manufacturière, etc.
Par exemple, dans la santé, les données synthétiques sont générées pour créer des dossiers de patients réalistes, ce qui facilite la recherche tout en offrant anonymisation et agrégation. Elles aident les chercheurs médicaux à développer et tester des algorithmes de diagnostic et de traitement tout en respectant des réglementations strictes en matière de protection des données.
Dans l’industrie manufacturière, les constructeurs automobiles utilisent des données synthétiques pour simuler de nombreux scénarios de conduite pour les véhicules autonomes. Cela aide à entraîner des modèles d’apprentissage automatique à reconnaître et à répondre à diverses conditions sans nécessiter une collecte extensive de données réelles. Des entreprises telles que Waymo et Tesla révolutionnent l’utilisation des données synthétiques pour entraîner leurs voitures autonomes.
Cadres réglementaires
- Le Règlement général sur la protection des données (RGPD) encadre le traitement des données personnelles dans l’UE et définit ce qui constitue des données anonymisées ou synthétiques.
- Le Data (Use and Access) Act 2025 au Royaume-Uni encadre le traitement et l’accès aux données personnelles et professionnelles. Il met à jour le cadre existant du RGPD britannique et du Data Protection Act.
- Aux États-Unis (Californie), le California Consumer Privacy Act (CCPA) et son amendement, le California Privacy Rights Act (CPRA), régissent la collecte et l’utilisation des données personnelles.
Paysage concurrentiel
Les acteurs clés du marché de la génération de données synthétiques misent largement sur l’innovation technologique continue. De nombreux acteurs de petite et moyenne taille ciblent des types de données et des secteurs spécifiques. Les fournisseurs spécialisés ne détiennent pas de part de marché dominante et opèrent sur des segments de niche.
Les grandes plateformes cloud et d’IA, telles que Microsoft et NVIDIA, entre autres, occupent une part importante du marché, les capacités en données synthétiques étant intégrées à des services d’IA et de ML plus larges. L’accent est également mis sur les partenariats et les acquisitions à des fins d’avantage stratégique.
- En mars 2025, Nvidia a acquis Gretel, une start-up de données synthétiques, pour plus de 320 millions USD, ce qui renforce sa suite de services d’IA générative destinés aux développeurs. Gretel entretient des partenariats avec de grands fournisseurs de cloud tels que Google Cloud, Amazon Web Services et Microsoft.
Entreprises clés du marché de la génération de données synthétiques :
- MOSTLY AI
- Datagen
- CVEDIA Inc
- K2view Ltd.
- Microsoft Corporation
- GenRocket, Inc
- TonicAI, Inc.
- NVIDIA (Gretel Labs)
- CapGemini (Sogeti)
- MDClone
Développements récents (partenariats)
- En avril 2023, MDClone a annoncé que sa plateforme ADAMS permet un nombre croissant de partenariats entre prestataires de soins de santé et entreprises des sciences de la vie, afin d’accélérer la recherche et le développement thérapeutiques.
Questions fréquemment posées
Quels sont les principaux moteurs du marché de la génération de données synthétiques ?
Quelles régions sont au cœur de la croissance de la génération de données synthétiques ?
À quels défis l’industrie de la génération de données synthétiques est-elle confrontée aujourd’hui ?
Quelles tendances façonnent l’avenir de la génération de données synthétiques ?
Quels sont les principaux acteurs de ce secteur ?
Quelles opportunités existent pour les investisseurs ?
Comment ce rapport m'aide-t-il à concentrer notre stratégie de croissance sur la région géographique la plus prometteuse ?
Comment ce rapport m'aide-t-il à comprendre quelle catégorie de DONNÉES a le plus grand impact économique ?
Auteur

Ashim Lakhera est un professionnel de l'intelligence de marché spécialisé dans l'industrie de l'agriculture et de l'alimentation et des boissons. Son travail se concentre sur les marchés émergents, la dynamique concurrentielle, les tendances du secteur et les facteurs qui stimulent la croissance et la transformation du marché. Il possède de l'expérience dans le dimensionnement des marchés, les prévisions, l'analyse stratégique et la recherche industrielle dans les domaines de l'alimentation, des produits de grande consommation et des sciences de la vie. Ses intérêts de recherche couvrent la chaîne de valeur alimentaire et agricole au sens large, avec un accent particulier sur la manière dont l'innovation, l'évolution du comportement des consommateurs, les priorités en matière de durabilité et l'évolution des systèmes de production influencent les marchés. Il examine ces développements pour comprendre leur impact sur la demande, la concurrence, les modèles commerciaux et les opportunités de croissance dans l’ensemble de l’écosystème agroalimentaire. Son travail combine une analyse quantitative du marché avec une compréhension des forces industrielles plus larges qui façonnent les marchés alimentaires et agricoles. Il s'intéresse particulièrement aux changements structurels qui se produisent dans les systèmes alimentaires mondiaux et à la manière dont les entreprises s'adaptent à l'évolution des attentes des consommateurs, aux développements technologiques et aux exigences de durabilité.
Révisé par

Habi est un leader chevronné en recherche et en conseil doté d'une expérience reconnue dans l'accompagnement de clients sur des initiatives stratégiques de croissance et de transformation sur les marchés mondiaux. Il a dirigé des équipes de recherche très performantes qui fournissent des informations exploitables sur l'expansion du marché, les stratégies de fusions et acquisitions, l'évaluation des opportunités, le développement de nouvelles affaires et les lancements de produits. Son portefeuille de projets couvre de grands producteurs pétrochimiques, des fabricants d'appareils électroniques, des sociétés de lubrifiants et d'autres entreprises de premier plan dans divers secteurs industriels et de consommation. Il dirige actuellement le département de recherche chez Kings Research, où il est chargé d'établir le programme de recherche, d'encadrer les analystes et de garantir que les livrables soient prêts pour le client et soutiennent la prise de décision de la direction. Fort d'une vaste expérience en matière d'intelligence de marché, de recherche stratégique et de conseil, Habi apporte une solide compréhension de l'évolution de la dynamique de l'industrie, des paysages concurrentiels, des opportunités émergentes et des défis de croissance des entreprises. Son expertise comprend le développement de cadres de recherche, la traduction de données de marché complexes en recommandations stratégiques exploitables et la collaboration étroite avec des parties prenantes de haut niveau pour répondre à des questions commerciales critiques. Il a également contribué au renforcement des capacités de recherche, au renforcement des méthodologies analytiques et à la promotion d’une culture de qualité et de prise de décision éclairée au sein des équipes de recherche. Son exposition intersectorielle lui permet de relier les tendances du marché aux implications commerciales plus larges et de fournir des perspectives qui aident les organisations à identifier les opportunités, à atténuer les risques et à prendre des décisions stratégiques éclairées.