


MARKT FÜR DIE GENERIERUNG SYNTHETISCHER DATEN (2025-2032)
Jetzt anfragen
Marktdefinition
Synthetische Daten sind künstliche Daten, die reale Daten nachahmen sollen. Sie werden künstlich generiert, behalten aber die statistischen Eigenschaften der Originaldaten bei, aus denen sie generiert wurden. Die Generierung synthetischer Daten kann in tabellarischer, multimedialer oder Textform erfolgen. Synthetische Textdaten können für die Verarbeitung natürlicher Sprache (NLP) nützlich sein. Ebenso finden tabellarische Daten Anwendung bei der Erstellung relationaler Datenbanktabellen.
Synthetische Multimediainhalte umfassen Bilder, Videos und andere unstrukturierte Daten, die unter anderem für Computer-Vision-Aufgaben wie Bilderkennung und Bildklassifizierung von entscheidender Bedeutung sein können. In Branchen wie Finanzwesen, Gesundheitswesen und Einzelhandel steigt der Datenbedarf. Synthetische Daten helfen solchen Organisationen, indem sie KI-Innovationen beschleunigen und intelligentere Entscheidungen ermöglichen.
Marktüberblick
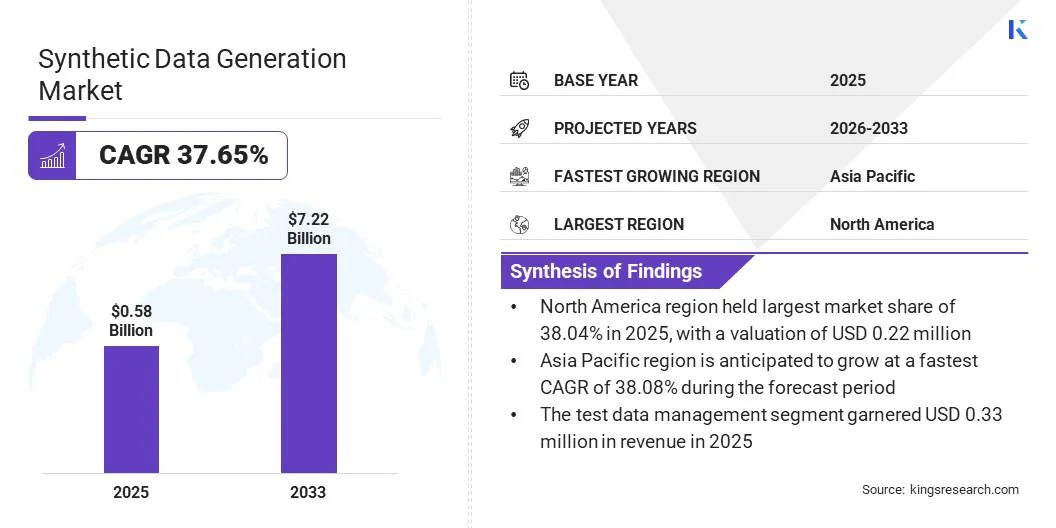
Die globale Marktgröße für die Generierung synthetischer Daten wurde 2025 auf 0,58 Milliarden US-Dollar geschätzt und wird voraussichtlich von 0,77 Milliarden US-Dollar im Jahr 2026 auf 7,22 Milliarden US-Dollar bis 2033 wachsen, was einer CAGR von 37,65 % im Prognosezeitraum entspricht. Dieses Wachstum wird auf die Anwendung synthetischer Daten für Testsysteme, das Training von KI-Modellen und die Simulation von Szenarien zurückgeführt, die in realen Daten im Allgemeinen schwer zu erfassen sind.
Im Gesundheitswesen können synthetische Krankenakten beispielsweise auf Erkrankungen wie Diabetes, Krankheit oder Krebs hinweisen, was bei der Entwicklung und Erprobung von Diagnosetools sowie prädiktiven Gesundheitsmodellen helfen kann.
Zu den wichtigsten Unternehmen, die auf dem globalen Markt für die Generierung synthetischer Daten tätig sind, zählen unter anderem MOSTLY AI, Datagen, TonicAI, Inc., GenRocket, Inc, NVIDIA (Gretel Labs), K2view Ltd., CapGemini (Sogeti), CVEDIA Inc, Microsoft Corporation und MDClone.
Es wird erwartet, dass die Nachfrage nach synthetischen Daten mit ihrer wachsenden Nutzung in mehreren Sektoren steigt, darunter in der Automobilbranche für das Testen von autonomen Fahrzeugen, im Gesundheitswesen für die medizinische Bildanalyse und die Patientendiagnose. Im Einzelhandel werden synthetische Daten vor allem für das Investmentmanagement und die Analyse des Kundenverhaltens eingesetzt.
Im Finanzwesen können synthetische Daten bei der Betrugserkennung und Risikobewertung von Vorteil sein. Der Hauptvorteil synthetischer Daten liegt in der Kosteneffizienz, Skalierbarkeit und Vielfalt. Sie werden hauptsächlich zum Training von Modellen für maschinelles Lernen verwendet. Sie bieten eine bessere Kontrolle über die Datenqualität und schützen außerdem die Privatsphäre, indem sie den Einsatz echter, sensibler Daten überflüssig machen.
Der jüngste Trend zeigt die Integration von föderiertem Lernen und Differential Privacy zur Verbesserung des datenschutzfreundlichen maschinellen Lernens. Außerdem wird die Nachfrage nach vielfältigen, hochwertigen Trainingsdatensätzen mit der Ausweitung der KI auf neue Bereiche wachsen, wodurch synthetische Daten sehr wichtig werden.
Wichtigste Highlights
- Die globale Marktgröße für die Generierung synthetischer Daten wurde 2025 auf 0,58 Milliarden US-Dollar beziffert.
- Der Markt soll von 2026 bis 2033 mit einer CAGR von 37,65 % wachsen.
- Nordamerika hielt 2025 einen Anteil von 38,04 % im Wert von 0,22 Milliarden US-Dollar.
- Das Segment Tabellendaten erzielte 2025 einen Umsatz von 0,20 Milliarden US-Dollar.
- Das Segment Testdatenmanagement wird bis 2033 voraussichtlich 4,05 Milliarden US-Dollar erreichen.
- Für das Segment Gesundheitswesen wird im Prognosezeitraum die höchste CAGR von 38,28 % erwartet.
- Asien-Pazifik wird im Prognosezeitraum voraussichtlich mit einer CAGR von 38,08 % wachsen.
Marktdynamik
Wie zuverlässig sind synthetische Daten für das KI-Training?
Synthetische Daten können, wenn sie mit robusten Verfahren generiert werden, bei der Modellleistung mit realen Daten mithalten oder diese in manchen Fällen sogar übertreffen, insbesondere bei seltenen Ereignissen.
Obwohl sie reale Daten nicht ersetzen können, sind sie bei der Unterstützung realer Daten sehr wirksam, insbesondere wenn ein Team mit begrenzten Daten, unausgewogenen Datensätzen oder Datenschutzbeschränkungen zu tun hat. Dadurch können sie realen Daten als leistungsstarke Ergänzung dienen, statt sie vollständig zu ersetzen.
- Im Oktober 2024 stellte MOSTLY AI seine neue Funktion für synthetischen Text zum Training von KI-Modellen vor, die zugleich den Datenschutz proprietärer Datenbestände wahrt. Sie hilft dem Unternehmen, eine breite Palette von Textdaten wie E-Mails, Chatbot-Gespräche und Kundensupport-Transkripte für das Training und die Feinabstimmung von großen Sprachmodellen (LLMs) zu nutzen, wobei kein Risiko einer Datenschutzverletzung besteht.
Warum muss beim Training von KI-Systemen bedacht werden, dass synthetische Daten zu falschen Ergebnissen führen können?
Synthetischen Daten können die Komplexität und Nuancen realer Daten fehlen, was dazu führen kann, dass KI-Modelle in realen Szenarien schlecht abschneiden. Zudem besteht die Möglichkeit, dass KI-Modelle, die vollständig auf synthetischen Daten trainiert wurden, aufgrund der Unterschiede zwischen synthetischen und tatsächlichen Daten nicht effektiv auf reale Situationen generalisieren können. Dies könnte bei einigen Anwendungen, etwa der medizinischen Diagnose, auch ethische Bedenken aufwerfen.
Wie bietet die Generierung synthetischer Daten geschäftliche Vorteile bei Kosten und Skalierbarkeit?
Die Erhebung realer Daten ist aufgrund von Sensoreinsatz, Kennzeichnung und Sicherheit kostspielig und langsam. Synthetische Daten für maschinelles Online-Lernen lassen sich dagegen einfacher, günstiger und schneller generieren. Synthetische Daten bieten kontrollierte und skalierbare Datenquellen für eine robuste KI-Entwicklung. Beispielsweise bieten Organisationen wie Nvidia und Databricks Tools wie Unity Catalog und Omniverse Replicator zur Automatisierung synthetischer Datenpipelines an. Schätzungen zufolge sind etwa 50 bis 60 % der für das Training von KI-Plattformen verwendeten Daten synthetisch. Die Nachfrage steigt, da synthetische Daten Unternehmen helfen, neue Produkte zu simulieren, die Entwicklung von KI-Modellen zu beschleunigen und sensible Informationen zu schützen.
- Im Oktober 2025 kündigte GenRocket die Einführung seines Unstructured Data Accelerator (UDA) an, mit dem das designorientierte Unternehmen für die Generierung synthetischer Daten seine Plattform über strukturierte Daten hinaus auf Bilder, Dokumente und dateibasierte Formate erweitert. Dies hat dem Unternehmen geholfen, jede Art von Daten sicher, präzise und bedarfsgerecht in großem Maßstab zu generieren.
Marktbericht im Überblick
|
Segmentierung |
Einzelheiten |
|
Nach Datentyp |
Tabellendaten, Textdaten, Bild- und Videodaten, Sonstige |
|
Nach Anwendung |
Testdatenmanagement, KI-Training und -Entwicklung, Unternehmensdatenaustausch, Datenanalyse und -visualisierung |
|
Nach Endnutzer |
Finanzdienstleistungen, Einzelhandel, Gesundheitswesen und Sonstige |
|
Nach Region |
Nordamerika: USA, Kanada, Mexiko |
|
Europa: Frankreich, Vereinigtes Königreich, Spanien, Deutschland, Italien, Russland, restliches Europa | |
|
Asien-Pazifik: China, Japan, Indien, Australien, ASEAN, Südkorea, restliches Asien-Pazifik | |
|
Naher Osten und Afrika: Türkei, VAE, Saudi-Arabien, Südafrika, restlicher Naher Osten und Afrika | |
|
Südamerika: Brasilien, Argentinien, restliches Südamerika |
Marktsegmentierung
- Nach Datentyp (Tabellendaten, Textdaten, Bild- und Videodaten und Sonstige): Das Segment Tabellendaten erzielte 2025 einen Umsatz von 0,20 Milliarden US-Dollar, vor allem aufgrund der wachsenden Akzeptanz im E-Commerce- und Gesundheitssektor. Es wird vor allem für das effektive Training einiger Modelle des maschinellen Lernens genutzt.
- Nach Anwendung (Testdatenmanagement, KI-Training und -Entwicklung, Unternehmensdatenaustausch und Datenanalyse und -visualisierung): Das Segment KI-Training und -Entwicklung dürfte im Prognosezeitraum eine beeindruckende CAGR von 38,08 % verzeichnen, angetrieben durch den breiten Bedarf am Training von Modellen für maschinelles Lernen. Es dient als potenzielle Lösung für Szenarien, in denen Daten benötigt werden, aber hochwertige reale Daten für das Training von KI-Modellen knapp sind.
- Nach Endnutzer (Finanzdienstleistungen, Einzelhandel, Gesundheitswesen und Sonstige): Das Segment Finanzdienstleistungen soll bis 2032 einen Anteil von 32,13 % halten, angetrieben durch Vorteile synthetischer Daten wie sichere Datenfreigabe und Modellentwicklung für Risikobewertung, Betrugserkennung und Analysen, ohne dabei echte Kundeninformationen preiszugeben. Die Generierung synthetischer Daten ist auch für seltene Ereignisse wie Marktabstürze oder komplexe Betrugsformen möglich, was zur Verbesserung der Modellleistung beiträgt und die KI-Entwicklung beschleunigt.
Regionale Analyse
Wie sieht das Marktszenario in Nordamerika und in Asien-Pazifik aus?
Nach Region gliedert sich der globale Markt für die Generierung synthetischer Daten in Nordamerika, Europa, Asien-Pazifik, den Nahen Osten und Afrika sowie Südamerika.
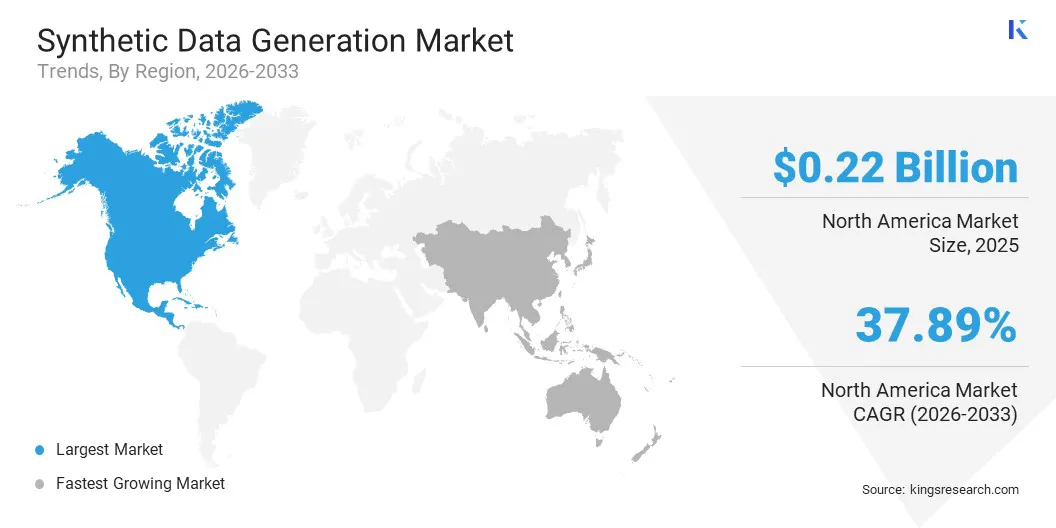
Der nordamerikanische Markt für die Generierung synthetischer Daten hielt 2025 einen Anteil von 38,04 % und war 0,22 Milliarden US-Dollar wert. Diese Dominanz ist auf eine Kombination aus fortschrittlicher technologischer Infrastruktur und höheren F&E-Investitionen in der Region zurückzuführen. Insbesondere in den USA setzen Unternehmen neueste Technologien ein, um Risiken und Ineffizienz zu verringern.
Zudem bevorzugen Verbraucher Marken, die sich auf inkrementelle Innovationen konzentrieren. Im Einzelhandel hilft die Generierung synthetischer Daten bei der Analyse von Kundenpräferenzen wie Einkaufsgewohnheiten und saisonaler Nachfrage, während gleichzeitig die Privatsphäre geschützt wird. Die Region hat wachsende Datenschutzpflichten und ein starkes KI-Ökosystem, was ein günstiges Umfeld für das Marktwachstum schafft.
- Im Juni 2021 kündigte CVEDIA eine Lösung für die Domänenanpassungslücke mithilfe der proprietären Pipeline für synthetische Daten an. Sie können bei der Entwicklung von KI helfen, indem sie es ermöglichen, dass auf synthetischen Daten trainierte Algorithmen ebenso gut abschneiden wie auf realen Daten trainierte. CVEDIA gab eine Präzisionsverbesserung von 170 % und einen nachhaltigen Zuwachs von 160 % beim Recall gegenüber Benchmark-Modellen an.
Der Markt für die Generierung synthetischer Daten in Asien-Pazifik soll im Prognosezeitraum mit einer CAGR von 38,08 % wachsen. Dieses bemerkenswerte Wachstum wird durch die zunehmende Nutzung synthetischer Daten in mehreren Bereichen der Region unterstützt, etwa im Gesundheitswesen und in der Fertigung.
Im Gesundheitswesen werden synthetische Daten beispielsweise generiert, um realistische Patientenakten zu erstellen, die die Forschung unterstützen und gleichzeitig Anonymisierung und Aggregation ermöglichen. Sie helfen medizinischen Forschern bei der Entwicklung und Erprobung von Algorithmen für Diagnose und Behandlung unter Einhaltung strenger Datenschutzbestimmungen.
In der Fertigung nutzen Automobilunternehmen synthetische Daten, um zahlreiche Fahrszenarien für autonome Fahrzeuge zu simulieren. Dies hilft beim Training von Modellen für maschinelles Lernen zum Erkennen und Reagieren auf verschiedene Bedingungen, ohne dass eine umfangreiche Erfassung realer Daten erforderlich ist. Unternehmen wie Waymo und Tesla revolutionieren den Einsatz synthetischer Daten beim Training ihrer selbstfahrenden Autos.
Regulatorische Rahmenbedingungen
- Die Datenschutz-Grundverordnung (DSGVO) regelt die Verarbeitung personenbezogener Daten in der EU und definiert, was als anonymisierte oder synthetische Daten gilt.
- Der Data (Use and Access) Act 2025 im Vereinigten Königreich regelt die Bestimmungen zur Verarbeitung und zum Zugriff auf personenbezogene und geschäftliche Daten. Er aktualisiert den bestehenden Rahmen der UK-DSGVO und des Data Protection Act.
- In den Vereinigten Staaten (Kalifornien) regeln der California Consumer Privacy Act (CCPA) und seine Ergänzung, der California Privacy Rights Act (CPRA), die Erhebung und Nutzung personenbezogener Daten.
Wettbewerbslandschaft
Die wichtigsten Akteure auf dem Markt für die Generierung synthetischer Daten konzentrieren sich vor allem auf kontinuierliche technologische Innovation. Es gibt viele kleine und mittelgroße Anbieter, die sich auf bestimmte Datentypen und Sektoren spezialisieren. Die spezialisierten Anbieter halten keinen dominanten Marktanteil und agieren in Nischensegmenten.
Große Cloud- und KI-Plattformen wie unter anderem Microsoft und NVIDIA halten einen bedeutenden Marktanteil, da synthetische Datenfunktionen in umfassenderen KI- und ML-Diensten enthalten sind. Der Fokus liegt zudem auf Partnerschaften und Übernahmen zur Erzielung strategischer Vorteile.
- Im März 2025 übernahm Nvidia für mehr als 320 Millionen US-Dollar Gretel, ein Startup für synthetische Daten, was seine Suite generativer KI-Dienste für Entwickler stärkt. Gretel unterhält Partnerschaften mit großen Cloud-Anbietern wie Google Cloud, Amazon Web Services und Microsoft.
Wichtige Unternehmen im Markt für die Generierung synthetischer Daten:
- MOSTLY AI
- Datagen
- CVEDIA Inc
- K2view Ltd.
- Microsoft Corporation
- GenRocket, Inc
- TonicAI, Inc.
- NVIDIA (Gretel Labs)
- CapGemini (Sogeti)
- MDClone
Aktuelle Entwicklungen (Partnerschaften)
- Im April 2023 gab MDClone bekannt, dass seine ADAMS-Plattform eine wachsende Zahl von Partnerschaften zwischen Gesundheitsdienstleistern und Biowissenschaftsunternehmen ermöglicht, um die therapeutische Forschung und Entwicklung zu beschleunigen.
Häufig gestellte Fragen
Was sind die Schlüsselfaktoren für den Software-Asset-Management-Markt?
Welche Herausforderungen behindern den Markt?
Wer sind die wichtigsten Akteure auf dem Markt?
Welche technologischen Fortschritte prägen den Markt?
Welche Regionen sind führend bei der Einführung von Software Asset Management?
Was sind die primären Endverbrauchssegmente für den Markt?
Welche Trends beeinflussen die Zukunft des Software-Asset-Management-Marktes?
Wie kann Ihnen dieser Bericht dabei helfen, die vielversprechendsten technologischen Veränderungen auf dem Markt zu identifizieren?
Wie können Sie diesen Bericht nutzen, um Investitionsmöglichkeiten auf dem Markt zu bewerten?
Wie hilft Ihnen dieser Bericht, die betrieblichen und kostenbezogenen Herausforderungen auf dem Markt zu verstehen?
Wie kann Ihnen dieser Bericht dabei helfen, Argumente für Investitionen in fortschrittliche Technologien für Software-Asset-Management-Operationen zu liefern?
Autor

Ashim Lakhera ist ein Market-Intelligence-Experte, der sich auf die Landwirtschaft sowie die Lebensmittel- und Getränkeindustrie spezialisiert hat. Seine Arbeit konzentriert sich auf Schwellenmärkte, Wettbewerbsdynamik, Branchentrends und die Faktoren, die das Marktwachstum und die Transformation vorantreiben. Er verfügt über Erfahrung in der Marktgrößenbestimmung, Prognose, strategischen Analyse und Branchenforschung in den Bereichen Lebensmittel, FMCG und Biowissenschaften. Seine Forschungsinteressen erstrecken sich über die breitere Wertschöpfungskette der Lebensmittel- und Landwirtschaft, wobei ein besonderer Schwerpunkt auf der Frage liegt, wie Innovation, verändertes Verbraucherverhalten, Nachhaltigkeitsprioritäten und sich entwickelnde Produktionssysteme die Märkte beeinflussen. Er untersucht diese Entwicklungen, um ihre Auswirkungen auf Nachfrage, Wettbewerb, Geschäftsmodelle und Wachstumschancen im gesamten Agrar- und Ernährungsökosystem zu verstehen. Seine Arbeit kombiniert quantitative Marktanalysen mit einem Verständnis der breiteren Branchenkräfte, die die Lebensmittel- und Agrarmärkte prägen. Sein besonderes Interesse gilt den strukturellen Veränderungen in den globalen Lebensmittelsystemen und der Art und Weise, wie sich Unternehmen an veränderte Verbrauchererwartungen, technologische Entwicklungen und Nachhaltigkeitsanforderungen anpassen.
Überprüft von

Habi ist ein erfahrener Forschungs- und Beratungsleiter mit renommierter Erfahrung in der Begleitung von Kunden bei strategischen Wachstums- und Transformationsinitiativen auf globalen Märkten. Er hat leistungsstarke Forschungsteams geleitet, die umsetzbare Erkenntnisse zu Marktexpansion, M&A-Strategien, Chancenbewertung, Neugeschäftsentwicklung und Produkteinführungen liefern. Sein Projektportfolio umfasst große petrochemische Hersteller, Hersteller elektronischer Geräte, Schmierstoffunternehmen und andere führende Unternehmen in verschiedenen Industrie- und Verbrauchersektoren. Derzeit leitet er die Forschungsabteilung bei Kings Research, wo er für die Festlegung der Forschungsagenda, die Betreuung von Analysten und die Sicherstellung kundengerechter Ergebnisse verantwortlich ist, die die Entscheidungsfindung der Geschäftsleitung unterstützen. Mit umfassender Erfahrung in den Bereichen Marktforschung, strategische Forschung und Beratung bringt Habi ein ausgeprägtes Verständnis für die sich entwickelnde Branchendynamik, Wettbewerbslandschaften, neue Chancen und Herausforderungen beim Unternehmenswachstum mit. Zu seinen Fachkenntnissen gehören die Entwicklung von Forschungsrahmen, die Umsetzung komplexer Marktdaten in umsetzbare strategische Empfehlungen und die enge Zusammenarbeit mit hochrangigen Stakeholdern zur Beantwortung kritischer Geschäftsfragen. Er hat auch dazu beigetragen, Forschungskapazitäten aufzubauen, analytische Methoden zu stärken und eine Kultur der qualitäts- und erkenntnisbasierten Entscheidungsfindung innerhalb von Forschungsteams voranzutreiben. Seine branchenübergreifende Präsenz ermöglicht es ihm, Markttrends mit umfassenderen geschäftlichen Auswirkungen zu verknüpfen und Perspektiven bereitzustellen, die Unternehmen dabei helfen, Chancen zu erkennen, Risiken zu mindern und fundierte strategische Entscheidungen zu treffen.